Article
1. Introduction
Cette page recense, à partir de la littérature scientifique publiée et vérifiée, les antécédents de l'intention d'accepter un robot de service dans les trois configurations d'hôtellerie-restauration étudiées cette année, en tire deux scénarios de modèle à tester, déclinés pour les trois groupes d'étudiants, et documente explicitement les arbitrages de validité discriminante qui ont conduit à retenir certains construits plutôt que d'autres. Elle suit la trame d'un article de recherche : d'où vient la question, ce que dit la littérature, comment l'inventaire a été construit, ce qu'il montre, ce qu'il faut en discuter et ce qu'il implique pour la collecte.
1.1 D'où vient la question : le parcours 2025-2026
La promotion 2025-2026 a travaillé sur le robot réceptionniste, le robot serveur et le robot cuisinier à partir d'une même question de terrain — les clients accepteront-ils d'être accueillis, servis ou nourris par un robot humanoïde ? — et d'un même modèle : l'anthropomorphisme perçu accroît l'utilité perçue et le plaisir anticipé, qui accroissent l'intention ; quatre risques perçus la réduisent. Les échelles ont été traduites et adaptées, le stimulus était une vidéo de dix secondes identique pour tous, et le modèle a été testé par équations structurelles (PLS-SEM) sur trois bases distinctes (206 répondants pour l'hébergement).
| Relation | Robot cuisinier | Robot réceptionniste | Robot serveur |
|---|---|---|---|
| Anthropomorphisme → utilité perçue | 0,62 *** | 0,67 *** | 0,68 *** |
| Anthropomorphisme → plaisir anticipé | 0,68 *** | 0,72 *** | 0,64 *** |
| Plaisir → intention | 0,46 *** | 0,60 *** | 0,53 *** |
| Utilité → intention | 0,43 *** | 0,28 *** | 0,37 *** |
| Risque vie privée → intention | −0,05 (ns) | −0,10 * | 0,01 (ns) |
| Autres risques (malaise, déshumanisation, emploi) → intention | ns | ns | ns |
| R² de l'intention | 0,77 | 0,81 | 0,75 |
*** significatif à 0,1 % · * significatif à 5 % · ns : non significatif. β : sens et force de l'effet ; R² : part de la variable expliquée par le modèle.
Plaisir anticipé et utilité perçue sont les deux moteurs de l'intention ; l'anthropomorphisme agit en amont ; parmi quatre risques, seule la vie privée freine directement, et seulement à la réception.
1.2 Ce qui reste à établir
- Validité externe. Chaque base a été recrutée séparément : les différences entre réception, salle et cuisine tiennent-elles au robot ou aux répondants ? Une réplication rigoureuse s'impose.
- Stimulus. Un seul robot, plutôt mécanique (anthropomorphisme perçu moyen : 1,86 sur 5). Un robot plus humain déclencherait-il davantage de plaisir… ou davantage de malaise ?
- L'énigme des risques sociétaux. Crainte pour l'emploi : 4,03 sur 5 ; déshumanisation : 4,16 sur 5. Et pourtant aucun effet direct sur l'intention. Frein ? Antécédent ? Condition ?
- Mesure. Plaisir et intention sont trop proches aux yeux des répondants : des items d'intention plus comportementaux (choisir, recommander) sont à construire.
1.3 Une réplication-extension
Le projet 2026-2027 est une réplication-extension d'un modèle antérieurement testé. Répliquer : tester à nouveau le socle établi en 2025-2026 dans trois contextes, avec un questionnaire au noyau identique et un stimulus homogène. Critiquer : reconstruire ce socle à partir de vos propres lectures et discuter ce que la littérature dit vraiment de la place des risques. Étendre : proposer et justifier une ou deux variables propres à votre robot et améliorer la mesure de l'intention. La recherche ne consiste pas toujours à inventer un modèle nouveau : répliquer, généraliser et étendre sont des contributions à part entière.
1.4 Trois robots, trois groupes
| Groupe | Robot | Question de départ | Ce qui change par rapport aux modèles usuels |
|---|---|---|---|
| G1 · L3 MHR hébergement | Robot de nettoyage des chambres (housekeeping) | Les clients accepteront-ils qu'un robot nettoie leur chambre d'hôtel ? | Le service s'exécute le plus souvent en l'absence du client et n'est jugé que sur son résultat : ni interface à manipuler, ni spectacle. |
| G2 · L3 MHR restauration | Robot serveur (prise de commande, service en salle) | Les clients accepteront-ils d'être servis par un robot humanoïde ? | Consommation publique et relationnelle ; la configuration la mieux documentée, et la plus contradictoire sur l'anthropomorphisme. |
| G3 · L3 MRC | Robot cuisinier en restauration collective (cuisine devant le convive et lui remet le plat) | Les convives accepteront-ils de consommer un plat préparé par un robot humanoïde ? | Le convive n'a pas choisi le prestataire ; le robot touche l'aliment ; aucune étude centrée sur l'usager n'existe en restauration collective. |
Le groupe hébergement change d'objet par rapport à 2025-2026 : le robot réceptionniste laisse place au robot qui nettoie la chambre. Ce déplacement n'est pas anodin : il retire au modèle deux de ses ressorts habituels — l'attente d'effort et le plaisir de l'interaction — et fait de la comparaison entre les trois groupes une comparaison entre un service invisible, un service public et un service alimentaire contraint.
1.5 Question de recherche, problématique et objectifs
La question de départ est celle du terrain : les clients accepteront-ils ce robot ? La problématique la reformule dans le langage de la science et relie des variables : quels sont les déterminants de l'intention d'accepter un robot de service, et la structure de ces déterminants diffère-t-elle selon la configuration de service — chambre, salle ou cuisine collective ? Trois objectifs en découlent, qui organisent la suite de cette page : inventorier les antécédents documentés par la littérature vérifiée, configuration par configuration (section 4) ; arbitrer leur validité discriminante en ne retenant qu'un construit par famille conceptuelle (sections 3.4 et 4.3) ; en déduire des hypothèses réfutables et un modèle à tester pour chaque groupe (section 6).
Sigles utilisés. PLS-SEM : modélisation par équations structurelles en moindres carrés partiels ; HTMT : rapport hétérotrait-monotrait, critère de validité discriminante (deux construits sont distincts si leur HTMT reste sous 0,85) ; PLS-MGA : comparaison des coefficients entre groupes ; MICOM : test d'invariance de mesure préalable à toute comparaison entre groupes ; SRPC : échelle de préoccupation de vie privée propre aux robots de service ; VD : variable dépendante.
2. Cadre théorique
Le cadre théorique procède du général au particulier : les cadres fondateurs du domaine, puis ce qui fonde l'adéquation entre un robot et une tâche, puis la congruence entre le robot et le positionnement de l'établissement, et enfin ce que la littérature dit de chacune des quatre configurations de service, avant deux éclairages complémentaires — les terrains asiatiques, où les clients ont réellement été servis par des robots, et la littérature francophone.
2.1 Existe-t-il un travail fondateur ?
La question mérite une réponse mesurée plutôt qu'une impression. Deux indicateurs ont été calculés. Le premier est la notoriété absolue, à savoir le nombre total de citations rapporté par l'API Semantic Scholar en septembre 2026, pour trente-huit candidats. Le second est le taux de co-citation à l'intérieur du domaine : pour trente articles empiriques récents du corpus, les références déposées auprès de Crossref ont été téléchargées — 2 558 références au total, dont 2 015 portant un DOI exploitable — et l'on a compté dans combien de ces trente bibliographies chaque candidat apparaît.
La distinction entre les deux indicateurs n'est pas cosmétique. La notoriété absolue favorise les références matricielles de la recherche en systèmes d'information, qui ne disent rien de spécifique sur les robots de service : Davis (1989) totalise 71 107 citations et Venkatesh et al. (2003) (article en visionneuse) 46 187, mais ces travaux situent le champ sans le différencier. Le taux de co-citation identifie au contraire le point de passage obligé de la littérature spécifique.
La réponse est alors nette. Le travail fondateur du domaine est l'article de Wirtz, Patterson, Kunz, Gruber, Lu, Paluch et Martins (article en visionneuse) publié en 2018 dans le Journal of Service Management sous le titre « Brave new world: Service robots in the frontline ». Il est cité dans quinze des trente bibliographies examinées, soit la moitié du corpus, et cette présence traverse les quatre configurations — nettoyage, service en salle, cuisine, méta-analyses. Avec 1 751 citations, il n'est pourtant pas le plus cité dans l'absolu : sa force est d'être incontournable. Il fournit le vocabulaire du champ, la typologie des tâches — cognitives-analytiques, cognitives-intuitives, émotionnelles-sociales — et le modèle d'acceptation à trois branches, fonctionnelle, socio-émotionnelle et relationnelle, que la plupart des auteurs reprennent ou amendent.
Deux piliers complètent ce socle. L'échelle de volonté d'intégration des robots de service de Lu, Cai et Gursoy (2019), présente dans douze bibliographies sur trente, est l'instrument de mesure standard de la variable dépendante du domaine. Et le modèle d'acceptation des dispositifs d'intelligence artificielle de Gursoy, Chi, Lu et Nunkoo (2019), présent dans huit bibliographies sur trente mais fort de 1 351 citations, est le modèle théorique le plus répliqué, y compris hors hôtellerie — Li et al. (2024) l'appliquent aux robots médicaux. C'est aussi celui dont le projet 2025-2026 était issu, ce qui en fait le point de comparaison naturel du travail 2026-2027.
Un dernier chiffre mérite d'être signalé, parce qu'il concerne directement le problème que cette note cherche à résoudre. Le critère HTMT de Henseler, Ringle et Sarstedt (2015) n'est cité que dans quatre des trente bibliographies examinées, et le critère de Fornell et Larcker (1981) dans dix. Autrement dit, deux tiers des études publiées dans ce domaine ne documentent leur validité discriminante par aucun de ces deux critères. Documenter sérieusement la sienne serait déjà, en soi, une contribution.
Une réserve technique s'impose sur ce second indicateur : Crossref ne recense que les références effectivement déposées par l'éditeur avec un DOI. Une référence citée sans DOI n'apparaît pas dans le décompte. Les taux ci-dessus sont donc des planchers, et Gursoy et al. (2019) est en particulier sous-estimé.
2.2 Ce que fonde la nature de la tâche : le socle théorique de l'adéquation robot-tâche
Sur quoi repose l'adéquation perçue robot-tâche, second construit du socle ? Sur une littérature abondante et convergente. Huang et Rust (2018) et Wirtz et al. (2018) (article en visionneuse) établissent que le remplacement par l'IA s'opère au niveau de la tâche, des intelligences mécaniques vers les intelligences empathiques. Castelo, Bos et Lehmann (2019), sur quatre études de laboratoire et deux études de terrain totalisant plus de 56 000 observations, montrent que les algorithmes sont moins utilisés pour les tâches subjectives et que l'objectivité perçue de la tâche est malléable. Longoni et Cian (2022) documentent l'effet « word-of-machine » : l'IA est jugée plus compétente en contexte utilitaire, moins en contexte hédonique. Liu, Wang et Wu (2026), sur 7 428 avis Ctrip et trois expériences, montrent qu'un service fonctionnel est mieux évalué lorsqu'il est rendu par un robot, et un service émotionnel lorsqu'il est rendu par un humain. Yang, Wang, Song et Ma (2024) fondent exactement un « robot-environment fit » par type de tâche sur la théorie person-environment fit. Enfin, la méta-analyse de Peng et al. (2026) — 46 expériences, 27 612 participants — fixe l'ordre de grandeur : une préférence pour l'humain faible en moyenne (d = −0,128) et entièrement conditionnelle au contexte, plus forte dans le luxe et les contextes domestiques, inversée dans les situations embarrassantes.
Ces résultats justifient un construit distinct de la compétence perçue : la compétence répond à la question « le robot en est-il capable ? », l'adéquation à la question « est-ce à lui de le faire ? ». Un robot compétent peut être inadéquat pour une tâche empathique, et un robot peu compétent adéquat pour une tâche embarrassante. Choi et al. (2020) en donnent la preuve empirique la plus nette : la qualité de résultat est jugée identique entre humain et robot, la qualité d'interaction ne l'est pas.
2.3 Congruence robot-marque et positionnement
Choi, Liu et Choi (2022) montrent que les robots à haut contact provoquent des réactions négatives pour une marque de personnalité sincère, non pour une marque excitante, par un fit perçu faible. Guan et al. (2025) répliquent en hôtellerie : la congruence entre le robot et la personnalité de marque nourrit l'amour de marque, la confiance médiatisant. Horng et al. (2025, 2026) introduisent deux congruences distinctes — luxury-technology fit et task-technology fit — qui médiatisent vers l'intention, à Taïwan comme aux États-Unis. Ma et al. (2025) documentent un « désavantage du robot » dans le luxe, par désir de supériorité : le robot ne procure pas le sentiment d'être servi en tant que client de statut. Chan et Tung (2019) trouvaient déjà un effet comportemental du robot positif en hôtellerie économique et de milieu de gamme, nul dans le luxe. Le positionnement de l'établissement est donc un modérateur robuste, à manipuler dans le scénario du groupe G2.
2.4 Le robot de nettoyage des chambres
La configuration est singulière : le service s'exécute le plus souvent en l'absence du client, sans aucune interaction, et il n'est jugé que sur son résultat. Trois conséquences théoriques en découlent, et chacune est un argument de spécification.
D'abord, l'attente d'effort et la motivation hédonique perdent leur objet. Le client n'utilise pas le robot et n'assiste pas au service : il n'y a ni interface à manipuler, ni spectacle, ni amusement. Or le plaisir anticipé était le chemin le plus fort du modèle 2025-2026. Son retrait doit être assumé et exposé comme un résultat théorique, non subi comme un oubli.
Ensuite, toute la branche relationnelle du modèle d'acceptation des robots de service de Wirtz et al. (2018) (article en visionneuse) devient inopérante, faute d'interaction. Et surtout, Choi et al. (2020) établissent, dans une expérience comparant service humain, service robotisé et service conjoint, que le personnel humain est perçu comme supérieur au robot sur la qualité d'interaction et sur l'environnement physique, mais qu'aucune différence significative n'apparaît sur la qualité de résultat. Dans un service jugé uniquement sur son résultat, le déficit du robot disparaît donc : c'est le meilleur appui théorique disponible pour ce sujet.
Enfin, les résultats de Hoang et Tran (2022) fournissent le squelette causal. La compétence perçue du nettoyeur est plus faible pour un robot que pour un humain (moyennes de 5,39 contre 5,88, p = 0,01), et cette moindre compétence dilue l'évaluation de la propreté du lieu puis réduit l'intention de visite. Mais deux modérateurs inversent ce désavantage : lorsque la tâche est répugnante, les consommateurs jugent le robot plus compétent que l'humain, par un mécanisme de préoccupation empathique ; et lorsque le nettoyage est perturbateur, le robot est préféré parce qu'il occasionne une perturbation sociale moindre. La salle de bains d'une chambre d'hôtel est le prototype de la tâche répugnante, et le passage d'une machine y est socialement moins intrusif que celui d'une personne — pas de salutation à échanger, pas de pourboire, pas de gêne.
Deux mécanismes complémentaires méritent d'être retenus. Shin et Kang (2020) montrent que le risque sanitaire perçu médie la relation entre l'interaction attendue et l'intention de réservation, et que la propreté perçue modère cet effet ; le robot, en supprimant l'interaction, réduit donc le risque sanitaire perçu. Magnini et Zehrer (2021) signalent à l'inverse que la présence visible du personnel de nettoyage est elle-même un indice subconscient de propreté : robotiser supprime ce signal heuristique. La tension entre ces deux mécanismes est testable.
Enfin, quatre construits propres à cette configuration n'existent nulle part dans la littérature vérifiée et constituent l'apport possible du groupe : l'intrusion territoriale perçue, le risque perçu pour les effets personnels, la préoccupation de surveillance et de cartographie de l'espace intime — un robot de nettoyage embarque caméras, LiDAR et cartographie tridimensionnelle —, et la préférence positive pour l'absence de contact humain, qui renverse la logique habituelle du besoin d'interaction en faisant de l'absence de contact un bénéfice et non un coût.
2.5 Le robot serveur en restauration commerciale
C'est la configuration la mieux documentée des quatre, et celle où la littérature est la plus contradictoire sur l'anthropomorphisme. Molinillo et al. (2022), sur 645 clients potentiels espagnols, trouvent que les perceptions hédoniques sont le premier déterminant de l'attitude (bêta = 0,293) et le premier réducteur d'objections après l'anthropomorphisme (bêta = −0,203). Mais Blut et al. (2021), dans une méta-analyse portant sur 11 053 individus et 108 échantillons indépendants, concluent à l'absence de consensus : l'effet de l'anthropomorphisme dépend du type de robot et du type de service. Xie et Lei (2022) établissent un effet non linéaire, en U inversé, de l'anthropomorphisme sur les préoccupations de vie privée. Kim et al. (2019) montrent qu'il accroît la chaleur perçue mais dégrade l'attitude par l'étrangeté. Mende et al. (2019) montrent qu'il provoque un inconfort et une menace pour l'identité humaine qui déclenchent des comportements de consommation compensatoire.
La leçon de spécification est claire : l'anthropomorphisme ne doit jamais être modélisé comme un antécédent exogène linéaire et positif, ce qui était précisément la spécification du modèle 2025-2026.
Trois construits sont, eux, propres au service en salle et bien établis. La chaleur perçue, dimension du modèle du contenu des stéréotypes, nourrit la valeur relationnelle attendue (Belanche et al., 2021) — avec un revers documenté par Choi et al. (2021) : une chaleur attendue plus élevée chez l'humanoïde produit davantage d'insatisfaction après un échec de processus. La sécurité physique perçue, mesurée par Jang et Lee (2020) et reprise par Molinillo et al. (2022) avec un bêta de 0,178 sur l'attitude, n'a d'équivalent dans aucune des autres configurations : le robot circule avec des plats chauds parmi les convives. L'authenticité, enfin, est le construit le plus sensible pour un terrain français : Song et al. (2022) montrent que le recours au robot aux niveaux cœur et facilitant du produit dégrade l'authenticité de service et de marque, et Cheng et al. (2026) établissent une dissociation décisive — le serveur humain nourrit l'authenticité morale, le robot nourrit l'authenticité du plat. Confondre les deux revient à annuler deux effets de signe opposé.
Un dernier résultat structure le terrain : Hu et Min (2025) montrent, sur deux expériences, que les restaurants de cuisine locale obtiennent de meilleures notes d'authenticité, de qualité, de congruence et d'intention de fréquentation avec un service intégralement humain, tandis que les établissements de restauration rapide et à thème futuriste obtiennent une congruence comparable quelle que soit la configuration. La légitimité du robot serveur dépend donc du positionnement de l'établissement, ce qui en fait un modérateur manipulable plutôt qu'une constante.
2.6 Le service robotisé en restauration collective
Le terrain étant vierge, la question devient : que faut-il emprunter, et à quoi ? La réponse tient en une observation. Les modèles dominants de l'acceptation technologique — TAM, UTAUT2 (article en visionneuse), AIDUA, modèle d'acceptation des robots de service — présupposent tous un consommateur libre de ses choix dans un marché concurrentiel. Le convive d'une cantine d'entreprise, d'un restaurant universitaire, d'un hôpital ou d'un établissement pénitentiaire n'adopte pas : il subit. Ces modèles ne sont donc pas seulement incomplets dans ce contexte, ils y sont mal spécifiés.
Le gisement pertinent est la littérature sur les technologies en libre-service en usage contraint, que la recherche sur les robots ignore presque entièrement. Lee et Kim (2026) en fournissent la transposition la plus directe : sur 389 personnes de 65 ans et plus, placées devant des scénarios de borne unique sans alternative humaine, ils montrent que la coercition perçue — définie comme la conscience subjective d'un choix structurellement contraint — augmente la perte d'autonomie perçue et l'affect négatif, qui prédisent tous deux l'intention d'évitement. Le résultat le plus instructif est que l'affect négatif domine l'évaluation cognitive : sous contrainte, l'émotion l'emporte sur le calcul. En amont, Reinders et al. (2008), Liu (2012), Reinders et al. (2015) et Feng et al. (2018) constituent le socle théorique de l'usage forcé et de la réactance.
Trois conséquences pratiques en découlent. D'abord, la variable dépendante doit changer : en contexte captif, l'intention d'utiliser a peu de variance, et c'est l'intention d'évitement — le report vers le sandwich, la gamelle ou l'extérieur — qui est comportementalement interprétable. Ensuite, la valeur perçue devient difficilement mesurable : en restauration subventionnée ou gratuite, le sacrifice monétaire tend vers zéro et le construit s'effondre sur l'utilité perçue. Deux hypothèses concurrentes s'ouvrent d'ailleurs à ce sujet, sans que la littérature permette de trancher : la gratuité abaisse-t-elle les exigences, ou fait-elle du repas un avantage social acquis dont la dégradation par la robotisation est lue comme une atteinte au contrat implicite ? Enfin, la captivité n'est pas binaire mais graduée — cantine d'entreprise en centre-ville, restaurant universitaire isolé, hôpital, établissement médico-social, détention — ce qui offre un plan quasi expérimental naturel que la restauration commerciale ne peut pas produire.
Deux construits spécifiques méritent d'être développés. La confiance institutionnelle d'abord : dans tout le corpus vérifié, la confiance porte sur le robot, alors qu'en restauration collective l'usager n'a pas choisi le prestataire. L'objet de confiance se déplace vers le décideur — l'employeur, l'université, l'hôpital, la collectivité — et la question devient : a-t-il robotisé pour mon confort ou pour réduire sa masse salariale ? La typologie de McKnight et al. (2002), qui sépare la confiance institutionnelle des croyances de confiance, fournit l'ancrage. La menace perçue sur l'emploi ensuite : aucune étude vérifiée ne la mesure comme antécédent significatif du côté du client. La preuve de non-significativité en restauration commerciale vient d'Etemad-Sajadi, Soussan et Schöpfer (2022) : sur 341 répondants suisses exposés à une vidéo de Pepper en service, le remplacement des travailleurs est la préoccupation éthique la plus élevée (moyenne de 5,25 sur 7) mais n'a aucun effet significatif sur l'intention d'utiliser le robot. Mais en restauration collective le convive connaît personnellement l'agent menacé, le croise hors du service, partage parfois son employeur. L'objection éthique cesse d'être abstraite, et l'hypothèse que ce construit devienne significatif lorsque la personne remplacée est identifiée et socialement proche est, à mon sens, le résultat le plus publiable que le projet puisse produire.
2.7 Le robot cuisinier qui cuisine devant le convive
Cette configuration croise trois littératures, et c'est ce croisement qui la rend intéressante.
La première est celle de la psychologie du consommateur alimentaire. Pancer et al. (2025), sur quatre expériences, établissent que l'automatisation de la préparation dégrade le goût anticipé, l'évaluation globale et la disposition à payer, en partie par deux effets de contagion distincts : l'aliment automatisé perd l'« amour » symbolique que lui transmettait le contact humain (contagion positive perdue), et le contact de la machine avec la nourriture accroît le dégoût (contagion négative) ; une communication centrée sur le bénéfice client atténue ce dégoût. Le mécanisme moral est établi séparément, par McShane, Taylor, Noseworthy, Pancer et Philp (2026) : un robot d'apparence humanoïde fait davantage inférer une intention de remplacer les travailleurs, ce qui réduit la moralité perçue du restaurant, puis ses évaluations et la fréquentation. La portée méthodologique est grande : dégoût de contact et indignation morale sont deux réactions distinctes, déclenchées par des indices différents — le contact machine-aliment d'un côté, l'apparence humanoïde de l'autre —, et un questionnaire qui ne les sépare pas mesure l'une en croyant mesurer l'autre.
La deuxième est celle de la néophobie. Ross et al. (2022), sur 1 045 répondants irlandais, trouvent que la néophobie technologique alimentaire, mesurée par l'échelle de Cox et Evans (2008), exerce l'effet total négatif le plus fort du modèle (bêta = −0,369, dont −0,167 en direct et −0,202 en indirect), et que la confiance en la science en est l'antidote le plus puissant (bêta = −0,445). C'est un levier de communication directement actionnable.
La troisième est celle de la transparence opérationnelle, et c'est là que se trouve l'angle mort le plus intéressant. Buell, Kim et Tsay (2017) établissent, sur deux expériences de terrain et deux expériences de laboratoire menées en restauration, que rendre le processus visible augmente la qualité perçue de 22,2 % et réduit le temps de traitement perçu de 19,2 %, par un mécanisme d'effort perçu : le client qui observe le travail l'apprécie davantage. Or aucune étude vérifiée n'a transposé ce mécanisme à un agent robotique. Et le mécanisme suppose un agent capable d'effort méritoire, condition qu'un robot ne remplit pas. L'hypothèse que la transparence opérationnelle ne produise aucun effet, voire un effet négatif, lorsque le cuisinier est une machine est à la fois la plus originale et la plus défendable du dossier.
Un dernier résultat doit être connu, parce qu'il contredit l'argument marketing le plus répandu. Byrd et al. (2024) montrent expérimentalement que les consommateurs préfèrent un serveur humain masqué à un robot propre et désinfecté : le robot n'est pas le dispositif de réassurance sanitaire que l'on suppose.
Deux tensions restent à trancher, et le projet en a les moyens. La première porte sur l'anthropomorphisme : Xiao et Zhao (2022) trouvent qu'il améliore la prédiction de qualité du plat, Lee et Kwak (2025) qu'il réduit l'appréciation attendue et la volonté d'essayer. L'hypothèse de réconciliation la plus plausible est que l'anthropomorphisme aide tant qu'il n'y a pas contact avec l'aliment, et nuit dès qu'il y en a — des mains humanoïdes plongées dans la nourriture activant une contagion symbolique au sens de Rozin et al. (1992). Lee et Kwak observent toutefois la préférence pour un robot moins anthropomorphe aussi bien pour le robot cuisinier que pour le robot serveur, et McShane et al. (2026) documentent un coût moral propre à la forme humanoïde en restauration : cette réconciliation reste une conjecture à tester, non un résultat établi. La seconde porte sur la confiance dans le respect des régimes alimentaires et des allergènes : la littérature consommateur est ici inexistante, alors que la question est centrale en restauration collective.
2.8 Ce qu'apportent les terrains asiatiques
Soixante références dont les terrains sont en Corée, en Chine, au Japon, à Taïwan, en Malaisie ou en Inde ont été vérifiées. Elles apportent ce que les terrains occidentaux ont rarement : des clients réellement servis par un robot. La série coréenne de Hwang, Kim et Choe compare systématiquement environ 300 clients servis par un robot à 300 clients servis par un humain ; Zhang et al. (2026) interrogent 433 clients de restaurants robotisés chinois ; Gong, Guan et Huan (2025) interrogent 269 clients sur site d'un restaurant à robot chef de Guangzhou ; Sthapit et al. (2024) étudient 429 séjours réels au FlyZoo Hotel d'Alibaba ; Fan, Gao et Han (2022) mènent une expérimentation de terrain de six mois dans 35 hôtels. S'y ajoutent des analyses d'avis massives : 4 107 avis Qunar sur 68 hôtels (Chang et al., 2022), Dianping pour Haidilao (Ma et al., 2023), 1 569 commentaires sur Henn-na Hotel (Yu, 2020).
Sur usage réel, la hiérarchie des antécédents devient très utilitaire : l'efficacité perçue représente 55 % des mentions dans les avis Qunar, la qualité de la nourriture et l'innovation technique expliquent la recommandation tandis que la qualité de service du robot ne l'explique pas (Li, Yuan & Zhao, 2025), et l'influence sociale disparaît ou n'agit qu'indirectement (Chang et al., 2022 ; Gong et al., 2026) alors qu'elle est centrale dans les modèles testés par scénario. Sur l'anthropomorphisme, les commentaires japonais sur Henn-na rejettent massivement les humanoïdes (73,5 % négatifs), l'acceptation est maximale pour un anthropomorphisme moyen (Jia, Chung & Hwang, 2021), et le robot d'apparence animale maximise émotions et chaleur (Cheng & Hwang, 2025) : le format « chat-robot » BellaBot qui domine en Asie n'est pas un hasard. Pour le robot en chambre, le contrôle perçu renforce l'acceptation (Song et al., 2024), les craintes de sécurité nocturne, de caméras et de piratage apparaissent spontanément (Yu, 2020), et la co-production est un antécédent de valeur (Tian & Liu, 2024). Sur le robot cuisinier, la nourriture prime, la compétence du robot chef conditionne l'évaluation alimentaire, et l'attitude anti-robot atténue les effets positifs (Gong et al., 2025) ; le besoin d'interaction humaine reste significatif même sur usage réel (Sung & Jeon, 2020). En revanche, aucune étude client asiatique vérifiable ne porte sur la restauration collective : le vide est le même qu'en Occident.
Trois précautions de transposition. Les répondants asiatiques ont une familiarité élevée avec les robots : les effets de nouveauté seront plus forts en France, et l'influence sociale peut y peser davantage, comme dans les études par scénario. Beaucoup d'études chinoises sont des scénarios et les échantillons coréens des panels en ligne : vérifier l'usage réel avant de transposer un coefficient. Enfin, une seule étude vérifiable teste les valeurs culturelles comme modérateurs (Chi, Chi, Gursoy & Nunkoo, 2023, États-Unis contre Chine) : distance hiérarchique et évitement de l'incertitude sont à réestimer sur un terrain français, non à importer.
2.9 La littérature francophone
Une recherche systématique a été menée par requêtes Crossref filtrées par revue (Décisions Marketing, Recherche et Applications en Marketing, Revue Française de Gestion, Management & Avenir, Téoros, Mondes du tourisme, Systèmes d'Information et Management, Gestion 2000, entre autres), sur HAL et sur theses.fr, de 2012 à 2026. Le constat est net : le corpus francophone à comité de lecture sur l'acceptation des robots de service par le client en hôtellerie-restauration est quasi inexistant. Trois articles francophones portent sur les robots, aucun en hôtellerie-restauration : Goudey et Bonnin (2016) montrent qu'un anthropomorphisme partiel aide les familiers du smartphone et nuit aux autres ; Passebois-Ducros et Flacandji (2022) étudient un robot à Lascaux IV ; Yang, Garnier et Djelassi (2025) montrent qu'un robot qui imite l'approche d'un vendeur accroît l'intrusivité perçue — résultat directement transposable au robot serveur qui s'approche de la table. Un seul article francophone croise IA, tourisme et client (Garcia et al., 2021, sur un chatbot touristique).
Cette absence est compensée de trois manières. D'abord par les laboratoires français publiant en anglais : Meyer-Waarden et Cloarec (2026, TSM Toulouse) sur l'éthicité perçue des robots sociaux en restaurant contre à domicile, le groupe Hasan et de Kervenoael (Tourism Management, 2020 ; JHTT, 2024), et El Halabi et Trendel (2024, Journal of Service Research), qui montrent que nommer un robot humanoïde réduit l'étrangeté perçue — un levier simple pour le malaise perçu du socle. Ensuite par les cadres francophones transposables sur les technologies en libre-service (Feenstra & Glérant-Glikson, 2017 ; Lao & Vlad, 2018 ; Ba & Vignon, 2013). Enfin par l'ancrage local en sociologie de l'alimentation : le CERTOP (Poulain ; Laporte & Poulain, 2014, sur la synchronisation sociale du repas d'entreprise) et la thèse en cours de David Rodriguez, dont la netnographie de réactions aux robots dans des restaurants français documente précisément l'effet de contamination du plat, le spectre de la suppression d'emplois et la politisation du repas — sur la plateforme expérimentale Ovalie de l'université. C'est un contact évident pour le projet.
3. Méthodologie
L'inventaire a été construit en cinq temps : délimiter les configurations de service, collecter et vérifier les sources, renseigner pour chaque antécédent une grille commune, appliquer des règles de spécification qui répondent au problème de validité discriminante rencontré en 2025-2026, et soumettre le résultat à un audit critique indépendant.
3.1 Périmètre : quatre configurations, trois groupes
L'inventaire distingue quatre configurations, parce que la littérature les distingue : C1, le robot qui nettoie les chambres d'hôtel ; C2, le robot serveur en restauration commerciale ; C3, le service robotisé en restauration collective, où le convive n'a pas choisi le prestataire ; C4, le robot cuisinier qui prépare le plat devant le convive et le lui remet. Les trois groupes s'y rattachent ainsi : G1 (MHR hébergement) travaille sur C1, G2 (MHR restauration) sur C2, et G3 (MRC) sur C4 appliqué en contexte C3 — le robot cuisinier en restauration collective combine les deux blocs, celui de l'aliment préparé par une machine et celui de l'usage contraint.
3.2 Collecte et vérification des sources
Trois cent neuf références sont mobilisées. Chacune a été contrôlée individuellement auprès de l'API Crossref : identifiant DOI, titre exact, liste d'auteurs, année, revue, volume et pagination. Les entrées bibliographiques au format APA 7 ont été produites directement à partir des métadonnées Crossref, sans ressaisie manuelle, ce qui élimine le risque d'erreur de transcription. Aucune référence dont l'existence n'a pas pu être confirmée n'a été conservée.
Une seconde règle s'applique au contenu : un résultat n'est jamais déduit d'un titre. Lorsque le résumé ou le texte intégral n'a pas pu être consulté, le classeur porte la mention correspondante et aucun sens d'effet n'est avancé. Cette distinction entre existence bibliographique et contenu vérifié est indiquée ligne par ligne.
Une réserve doit être signalée sur les dates. Crossref renvoie fréquemment l'année de mise en ligne, distincte de l'année du numéro ; l'écart atteint un à deux ans pour plusieurs articles du corpus. La bibliographie retient l'année du numéro lorsque Crossref la fournit, et ne retombe sur la date de mise en ligne qu'à défaut — ce qui corrige, par exemple, la date de Henseler, Ringle et Sarstedt (2015).
Les sources ont été recherchées par requêtes ciblées configuration par configuration (celles de la restauration collective sont décrites en 4.1), complétées par une recherche dédiée aux terrains asiatiques (section 2.8) et par une recherche systématique de la littérature francophone à comité de lecture (section 2.9). Les références de littérature grise — thèses, communications — ont été vérifiées sur HAL ou theses.fr.
3.3 La grille d'inventaire
Chaque antécédent identifié occupe une ligne du classeur, dans l'onglet de sa configuration, avec quatorze colonnes : le code, l'intitulé en français et en anglais, la définition opérationnelle, la famille conceptuelle, les recherches qui le mobilisent, le contexte et la méthode de ces recherches, le sens de l'effet sur l'intention, le coefficient ou la taille d'effet lorsqu'ils ont pu être vérifiés, l'échelle de mesure d'origine, la justification de sa pertinence pour le contexte, son statut empirique, son risque de recouvrement avec d'autres construits, et la décision retenue pour le modèle. Le statut empirique distingue trois situations : testé, un résultat empirique existe dans ce contexte précis ; transposition, le résultat a été établi dans un contexte voisin et doit être retesté ; nouveau, le construit est proposé et n'a jamais été testé — c'est l'espace de contribution du projet. La décision indique ce qu'il advient du construit : retenu au socle commun, retenu en extension de contexte, manipulé dans le stimulus, modérateur, variable de contrôle, fusionné dans un autre construit, ou écarté pour une raison explicite, le plus souvent un recouvrement conceptuel.
3.4 Les règles de spécification
De ce diagnostic découlent dix règles de spécification, détaillées dans le tableau ci-dessous et dans le classeur. Les quatre plus importantes sont les suivantes.
- Un seul construit mesuré par famille conceptuelle. Retenir la compétence perçue signifie abandonner explicitement les onze autres membres de sa famille, et traiter l'assurance de service ou l'intelligence perçue comme des indicateurs de ce construit et non comme des construits distincts.
- Jamais attitude et intention dans le même modèle. L'attitude spécifique envers le robot est supprimée et les antécédents pointent directement vers l'intention ; l'attitude générale envers les robots est conservée, mais comme variable de contrôle exogène, parce qu'Ivanov et Webster (2019) établissent que c'est le meilleur prédicteur unique de la volonté d'utiliser un robot et que ne pas la contrôler gonflerait artificiellement tous les construits spécifiques.
- Manipuler plutôt que mesurer ce qui peut l'être. L'apparence du robot est manipulée par deux versions de la vidéo stimulus, mécanoïde et anthropomorphe, au lieu d'être mesurée. Cette seule décision retire du modèle de mesure toute la famille de l'humanité du robot, qui est la première source de recouvrement du domaine — et qui était l'antécédent exogène principal du modèle 2025-2026.
- Séparer strictement les traits et les états. Un trait — anxiété technologique, néophobie, aversion aux germes — est un modérateur ou une covariable ; un état — malaise, propreté perçue, risque perçu — est un antécédent ou un médiateur. La confusion des deux est une source classique de HTMT élevé, et elle est fréquente dans ce corpus.
Les six autres règles portent sur l'unicité de la variable dépendante, l'ancrage explicite de chaque batterie d'items sur son objet, le plafonnement à six ou huit construits latents, le pré-test cognitif avant collecte plutôt que la purification après coup, la publication du HTMT avec intervalles de confiance bootstrap et un seuil conservateur de 0,85, et la préférence pour les chaînes causales sur les faisceaux de prédicteurs parallèles.
| Règle | Énoncé | Mise en œuvre |
|---|---|---|
| R1 | Une seule mesure par famille conceptuelle | Les familles F1 à F13 de l'onglet Recouvrements HTMT recensent les construits qui mesurent la même chose. En retenir plus d'un par famille produit mecaniquement un HTMT élevé. |
| R2 | Jamais attitude ET intention dans le même modèle | L'attitude spécifique envers le robot est supprimee ; les antécédents pointent directement vers l'intention. L'attitude GÉNÉRALE envers les robots reste, mais en contrôle exogene. |
| R3 | Deux variables dépendantes distinctes, et rien d'autre | Une intention d'acceptation et une intention d'évitement, mesurées dans les trois groupes, dont la distinction est vérifiée par AFC (HTMT < 0,85). Pas d'empilement willingness / visite / recommandation / revisite. |
| R4 | Manipuler plutôt que mesurer ce qui est manipulable | Apparence du robot, dégoût et perturbation de la tâche, visibilité de la préparation, information préalable, type d'établissement, signal de confidentialite. Chaque manipulation retire une famille entière du modèle de mesure. |
| R5 | Séparer strictement traits et états | Un trait (anxiété technologique, néophobie, aversion aux germes) est un MODÉRATEUR ou un contrôle. Un état (malaise, propreté perçue, risque perçu) est un antécédent ou un médiateur. La confusion des deux est une source classique de HTMT élevé. |
| R6 | Ancrer chaque batterie d'items sur un objet explicite | Ce robot... / cet établissement... / mon employeur... / mes affaires... / mon régime alimentaire... Deux construits distincts dont les items ne nomment pas leur objet fusionnent chez le répondant. |
| R7 | Plafonner à huit construits latents antécédents par groupe | Au-delà, la matrice HTMT devient ininterprétable et le modèle indefendable en soutenance. G3 à ete ramene à huit antécédents latents par l'arbitrage (coercition en variable de contexte, opposition morale au remplacement (McShane et al., 2026) fusionnée dans la menace sur l'emploi [texte corrigé, voir section 5.2]). |
| R8 | Pre-tester les items avant la collecte, pas purifier après | Supprimer des items après coup pour faire passer le HTMT revient à redéfinir le construit sans le dire. Un pré-test cognitif sur une dizaine de répondants suffit à detecter les items qui fusionnent. |
| R9 | Rapporter le HTMT avec intervalles de confiance bootstrap | Henseler, Ringle & Sarstedt (2015). Seuil conservateur à 0,85 pour des construits conceptuellement proches, et non 0,90. Rapporter aussi le critère de Fornell & Larcker (1981) et les charges croisees. Rappel : ces deux critères ne sont cités que dans 13 % et 33 % des 30 articles du corpus. |
| R10 | Préférer les chaînes causales aux prédicteurs paralleles | Lee & Kim (2026) en donnent l'exemple : plusieurs construits voisins modelises en séquence plutôt qu'en faisceau vers la même variable dépendante limitent à la fois le HTMT et le VIF. Application : propriété psychologique -> intrusion territoriale (G1) ; besoin d'interaction -> gêne anticipée -> acceptation (G1). |
3.5 L'audit critique
L'inventaire et le modèle qui en découle ont ensuite été soumis à une relecture critique indépendante, conduite à partir des textes publiés. Pour chaque antécédent, l'audit a établi le chemin réellement soutenu par la source — la relation effectivement testée dans l'article, qui n'est pas toujours celle que l'on voudrait lui faire dire —, un niveau de preuve à quatre degrés (direct : étudié sur le même type de robot et de contexte ; proche : robot ou hospitalité voisins ; transposition : autre technologie ou autre contexte ; nouveau : jamais testé), une décision et un rôle recommandé dans le modèle. Les références déterminantes ont été relues sur le site des éditeurs, sur PubMed ou dans les versions en accès ouvert. Cet audit a conduit à corriger une erreur de lecture (section 5.2), à re-spécifier plusieurs hypothèses et à proposer, à côté du modèle étendu, un modèle parcimonieux : ce sont les deux scénarios de la section 6.
4. Résultats
Les résultats sont de trois ordres : ce que le corpus ne contient pas, ce qu'il contient — l'inventaire des antécédents, consultable ci-dessous de façon dynamique —, et ce que sa lecture en colonnes révèle de la structure conceptuelle du domaine.
4.1 Deux absences qui sont des résultats
Deux constats méritent d'être posés d'emblée, parce qu'ils conditionnent tout le reste.
Premièrement, aucune étude empirique publiée ne teste un modèle d'acceptation sur le cas précis d'un robot qui nettoie une chambre d'hôtel occupée. Le seul travail qui s'en approche réellement est celui de Hoang et Tran (2022), publié dans Tourism Management, qui porte sur des robots nettoyeurs évalués par des consommateurs dans des lieux touristiques, hôtels et aéroports. Trois autres travaux — Ivanov et Webster (2019), Alma Çallı et al. (2022), Binesh et Baloglu (2023) — mesurent l'intention d'usage ventilée par département hôtelier, le housekeeping y figurant explicitement, mais sans modèle causal propre à cette tâche.
Deuxièmement, aucune étude empirique centrée sur l'usager n'a pu être identifiée en restauration collective. Les requêtes croisant restauration institutionnelle, cantine d'entreprise, restauration universitaire, restauration scolaire, restauration hospitalière et milieu pénitentiaire avec robot, acceptation, intention, TAM et UTAUT ne renvoient que trois types de résultats : de l'ingénierie informatique sans modèle comportemental, de la recherche nutritionnelle et environnementale sur la restauration scolaire, et des travaux sur le robot d'assistance sociale ou logistique en établissement de soin qui n'abordent pas le service alimentaire du point de vue du convive.
Ces deux absences ne sont pas un défaut de recension : elles délimitent l'espace de contribution du projet, et elles imposent de raisonner par transposition argumentée plutôt que par réplication.
4.2 L'inventaire des antécédents
L'inventaire complet compte 135 lignes, dont 129 antécédents rattachés à l'une des treize familles conceptuelles (45 pour le nettoyage des chambres, 33 pour le robot serveur, 25 pour la restauration collective, 26 pour le robot cuisinier) ; les autres lignes sont des éléments de cadrage ou d'état des lieux. L'audit en a repris 38, ceux qui comptent pour les trois groupes, en qualifiant pour chacun le niveau de preuve (29 directs, 2 proches, 4 transpositions, 3 nouveaux) et la décision (10 à retenir, 14 optionnels ou conditionnels, 4 en contrôle ou modérateur, 2 à manipuler dans le stimulus, 8 écartés ou exploratoires).
Le tableau ci-dessous se lit par onglet — l'inventaire audité, puis chaque bloc de configuration, puis les familles conceptuelles —, se filtre par groupe, famille, niveau de preuve ou décision, se trie par colonne et se recherche en texte intégral. Cliquer sur une ligne affiche toutes les colonnes de la grille : définition, méthode, coefficient vérifié, échelle d'origine, justification. Le classeur est aussi téléchargeable.
| Groupe | Antécédent | Famille | Sens | Niveau de preuve | Décision | Rôle recommandé |
|---|---|---|---|---|---|---|
| G1 | Compétence / performance perçue du robot | Performance | + | DIRECT + méta-analyse hôtelière | RETENIR | Socle commun |
| G1 | Adéquation robot–tâche / robot–environnement | Fit / appropriateness | + | DIRECT | RETENIR | Socle commun |
| G1 | Propreté anticipée / perçue de la chambre | Outcome quality | + | DIRECT | RETENIR | Médiateur contextuel |
| G1 | Préoccupations de vie privée / SRPC | Privacy risk | − | PROCHE HOSPITALITÉ | RETENIR UNE SEULE MESURE | Extension contextuelle |
| G1 | Caractère dégoûtant de la tâche | Task disgust | ± | DIRECT | OPTIONNEL | Manipulation seulement |
| G1 | Caractère perturbateur de la tâche | Task disruption | ± | DIRECT | OPTIONNEL | Manipulation seulement |
| G1 | Risque sanitaire / valeur du sans-contact | Health risk | + | PROCHE HÔTEL | CONTRÔLE / CONTEXTE | Contrôle situationnel |
| G1 | Intrusion territoriale perçue | Territoriality | ± | NOUVEAU | ÉCARTER DU MODÈLE PRINCIPAL | Exploratoire qualitatif |
| G1 | Risque pour les effets personnels | Specific risk | − | NOUVEAU | ÉCARTER DU MODÈLE PRINCIPAL | Exploratoire |
| G1 | Aversion aux germes | Trait | + | TRANSPOSITION | CONTRÔLE / MODÉRATEUR EXPLORATOIRE | Covariable |
| G2 | Performance expectancy / compétence | Performance | + | DIRECT RESTAURANT | RETENIR UN SEUL CONSTRUIT | Socle commun |
| G2 | Plaisir / motivation hédonique | Affect positif | + | DIRECT RESTAURANT | RETENIR | Extension G2 |
| G2 | Manipulation hygiénique perçue | Food safety | + | DIRECT ROBOT WAITER | RETENIR | Extension G2 |
| G2 | Influence sociale | Social norm | + | DIRECT ROBOT WAITER | OPTIONNEL | Extension secondaire |
| G2 | Effort expectancy / facilité | Ease of use | + | DIRECT | NON PRIORITAIRE | Variable de robustesse |
| G2 | Innovativité perçue / personnelle | Novelty / trait | + | DIRECT | CONTRÔLE / SEGMENTATION | Covariable |
| G2 | Sécurité physique perçue | Physical safety | + | DIRECT MAIS MÉDIÉ | NE PAS METTRE EN DIRECT SANS SOURCE ADÉQUATE | Option médiée |
| G2 | Qualité d'interaction | Interaction quality | + | DIRECT MAIS MÉDIÉ | ÉCARTER DU MODÈLE COURT | Discussion |
| G2 | Authenticité de service / marque | Authenticity | + | DIRECT CONTEXTUEL | OPTIONNEL SI RESTAURANT TRADITIONNEL | Extension de contexte |
| G2 | Chaleur perçue | Warmth | + | DIRECT HOSPITALITY | ÉCARTER DU MODÈLE COURT | Médiation éventuelle |
| G2 | Anthropomorphisme | Robot humanity | ± | DIRECT/PROCHE | MANIPULER OU FIXER, NE PAS MESURER | Facteur de stimulus |
| G2 | Risque perçu global | Risk | − | DIRECT RESTAURANT | ÉCARTER EN GLOBAL | Discussion |
| G3 | Fonctionnalité / performance | Performance | + | DIRECT ROBOT CHEF | RETENIR UN SEUL CONSTRUIT | Socle commun |
| G3 | Plaisir / expected enjoyment | Affect positif | + | DIRECT ROBOT CHEF | OPTIONNEL | Extension positive |
| G3 | Barrière d'authenticité | Authenticity | − | DIRECT ROBOT CHEF | RETENIR | Extension G3 |
| G3 | Inflexibilité perçue | Adaptability | − | DIRECT ROBOT CHEF | OPTIONNEL | Extension secondaire |
| G3 | Barrière gustative / qualité anticipée | Food quality | + | DIRECT ROBOT CHEF | RETENIR | Extension G3 / outcome alimentaire |
| G3 | Dégoût lié au contact machine–aliment | Negative contagion | − | DIRECT FOOD AUTOMATION | OPTIONNEL | Mécanisme affectif alternatif |
| G3 | Amour perçu dans l'aliment | Positive contagion | + | DIRECT FOOD AUTOMATION | NE PAS CUMULER AVEC AUTHENTICITÉ | Médiateur si comparateur humain |
| G3 | Néophobie technologique alimentaire | Trait | − | DIRECT ROBOT CHEF + échelle générale | CONTRÔLE / MODÉRATEUR CIBLÉ | Covariable |
| G3 | Information positive / cadrage | Framing | + | DIRECT | OPTIONNEL | Manipulation |
| G3 | Anthropomorphisme du robot cuisinier | Robot humanity | ± | DIRECT ROBOT CHEF | MANIPULER OU FIXER | Facteur de stimulus |
| G3 | Inférence de remplacement de l'emploi / moralité du restaurant | Moral judgment | − | DIRECT FOODSERVICE | OPTIONNEL MAIS SOLIDE | Extension morale |
| G3 | Inattendu / creepiness | Affect négatif | − | DIRECT ROBOT CHEF | OPTIONNEL, PAS AVEC DISGUST | Médiation affective alternative |
| G3 | Coercition perçue / absence d'alternative | Constraint | + | TRANSPOSITION SST, personnes âgées | SECONDAIRE UNIQUEMENT SI SCÉNARIO CAPTIF | Branche secondaire |
| G3 | Transparence opérationnelle | Operational transparency | + | TRANSPOSITION HUMAINE | EXPLORATOIRE | Manipulation future |
| G3 | Confiance régimes/allergènes | Dietary compliance trust | + | NOUVEAU | ÉCARTER DU MODÈLE PRINCIPAL | Exploratoire qualitatif |
| G3 | Confiance institutionnelle | Institutional trust | + | TRANSPOSITION LOINTAINE | ÉCARTER DU MODÈLE PRINCIPAL | Exploratoire |
4.3 Un espace conceptuel encombré : treize familles de construits
Le modèle 2025-2026 a dû être nettoyé en raison de recouvrements entre construits. Ce n'est pas un accident local : c'est une caractéristique structurelle de cette littérature, et il est possible de le montrer sur les travaux publiés eux-mêmes.
Trois exemples suffisent. Chez Molinillo et al. (2022), l'intention de recommander prédit la volonté d'accepter avec un bêta de 0,781 et un R² de 0,736 : un coefficient de cette magnitude entre deux intentions est un signal de recouvrement, pas un résultat substantiel. Chez Marghany et al. (2025), l'attitude prédit l'intention à 0,565 pendant que l'effet direct de l'attente de performance devient non significatif et négatif (bêta = −0,036) : configuration typique d'un recouvrement entre attitude et intention autant que d'une médiation véritable. Et dans la méta-analyse de Begum et al. (2025), la présence sociale perçue est qualifiée de plus mauvais prédicteur alors que sa corrélation avec l'intention atteint 0,594, les auteurs suspectant une relation confondue par des variables externes — ce qui est exactement la signature d'un problème de validité discriminante non diagnostiqué.
L'inventaire regroupe les construits recensés en treize familles conceptuelles, c'est-à-dire treize ensembles de termes qui mesurent la même chose sous des noms différents. La famille de la performance en compte douze : utilité perçue, attente de performance, efficacité, fonctionnalité, consistance, assurance de service, qualité de résultat, intelligence perçue, bénéfices perçus, valeur fonctionnelle, compétence perçue et facette « performance » de la confiance. La famille de l'humanité du robot en compte neuf, dont l'anthropomorphisme et la présence sociale automatisée, qui partagent littéralement les mêmes items chez la plupart des auteurs.
5. Discussion
5.1 Ce que la littérature établit, et ce qu'elle ne permet pas d'affirmer
Trois enseignements se dégagent de l'inventaire. Le premier est la robustesse des deux moteurs déjà observés en 2025-2026 : la croyance que la machine fera bien le travail — compétence, utilité, attente de performance, autant de noms pour une même croyance — et, là où il y a interaction, le plaisir anticipé. Ils reviennent dans toutes les configurations, sur scénario comme sur usage réel, et, pour le premier, la méta-analyse de Begum et al. (2025) en fixe l'ordre de grandeur en hôtellerie (r = 0,71 pour l'attente de performance). Le deuxième est que la question « est-ce à lui de le faire ? » est distincte de la question « en est-il capable ? » : la littérature sur la nature de la tâche (section 2.2) fonde un construit d'adéquation robot-tâche qui n'existait pas dans le modèle 2025-2026 et qui est, avec la compétence, le seul chemin que l'audit juge strictement comparable entre les trois groupes (scénario A, section 6.2) ; le scénario B y ajoute le malaise perçu et le besoin d'interaction humaine, et le plaisir anticipé hors hébergement. Le troisième est que l'anthropomorphisme ne doit plus être modélisé comme un antécédent exogène, linéaire et positif : ses effets sont non linéaires, contradictoires selon les études et porteurs d'un coût moral propre à la forme humanoïde ; le manipuler plutôt que le mesurer est la réponse la plus sûre.
Configuration par configuration, la littérature est inégale. Pour le nettoyage des chambres, une seule étude fournit un squelette causal directement transposable — Hoang et Tran (2022) : compétence perçue, propreté anticipée, avantage du robot pour les tâches répugnantes — et la préoccupation de vie privée dispose d'une échelle validée en hospitalité (Jia, Chi & Lu, 2024) ; tout le reste — intrusion territoriale, surveillance, effets personnels — est nouveau et non validé. Pour le robot serveur, les antécédents directs les mieux établis sont récents et convergents : plaisir anticipé et manipulation hygiénique perçue (Figueiredo et al., 2026), motivation hédonique et attente de performance (Topsakal et al., 2026) ; la chaleur et la sécurité physique agissent par des chemins médiés — valeur relationnelle, attitude — que les sources ne présentent pas comme des effets directs, et l'authenticité ne compte que si le scénario est explicitement traditionnel ou local. Pour le robot cuisinier, trois littératures se croisent sans se recouvrir : les raisons contre l'acceptation propres à la cuisine robotisée — barrière d'authenticité, inflexibilité, barrière gustative (Huang et al., 2023) —, les deux effets de contagion de l'automatisation alimentaire (Pancer et al., 2025) et l'inférence morale de remplacement de l'emploi déclenchée par la forme humanoïde (McShane et al., 2026). Enfin, la restauration collective reste un terrain vierge : ce que l'on en dit se transpose de la littérature sur les technologies en libre-service en usage contraint, et doit être présenté comme tel.
Ce que l'inventaire ne permet pas d'affirmer mérite d'être dit aussi nettement. Aucune relation universelle entre apparence du robot et acceptation n'est établie. Aucune étude ne mesure la menace sur l'emploi comme antécédent direct et significatif de l'intention du côté du client (Etemad-Sajadi et al., 2022 : non significatif) ; le seul effet établi passe par la moralité perçue du restaurant, et il est déclenché par la forme humanoïde (McShane et al., 2026). Aucun résultat quantitatif à comité de lecture sur échantillon français n'existe. Et plusieurs des construits les plus séduisants du corpus — amour perçu dans l'aliment, transparence opérationnelle, coercition perçue — n'ont été testés qu'avec un comparateur humain ou dans un autre contexte : les inscrire dans un modèle sans ce comparateur revient à leur faire dire ce qu'ils n'ont pas démontré.
5.2 Points de vigilance issus de l'audit
L'audit critique (section 3.5) a passé au crible le modèle étendu. Ses conclusions sont reproduites ci-dessous, par ordre de priorité : deux points forts à conserver, et une série de corrections qui portent sur la lecture d'une source, sur la cohérence des construits et sur le plan d'analyse. Elles sont la matière première de l'arbitrage entre les deux scénarios de la section 6. La numérotation des hypothèses est celle du scénario étendu.
P0 Erreurs à corriger en priorité
- P0
Lecture de Pancer et al. (2025)
Erreur critiqueDiagnostic. Erreur substantielle : le dégoût n'est pas présenté comme « moral » ou lié au remplacement de l'emploi. L'article l'explique par une contagion négative liée au contact de la machine avec l'aliment ; l'absence d'« amour » relève d'une contagion positive perdue liée au contact humain.
Pourquoi c'est important. Cette erreur change entièrement H23 (ex-H20) et le mécanisme proposé pour le robot cuisinier.
Correction recommandée. Remplacer « dégoût moral » par « dégoût / contagion négative liée au contact machine-aliment ». Pour le mécanisme moral d'emploi, utiliser McShane et al. (2026).
État dans cette version. Corrigé dans cette version : le texte du cadre théorique et les ancrages du scénario étendu (H19, H23) distinguent désormais les deux effets de contagion (Pancer et al., 2025) du mécanisme moral (McShane et al., 2026).
- P0
H4b besoin d'interaction humaine en G1
Erreur conceptuelleDiagnostic. Le signe positif est incohérent avec la définition du construit : un fort besoin d'interaction humaine ne peut pas signifier une préférence pour l'absence de contact.
Pourquoi c'est important. Risque de construit inversé et de HTMT/codage incohérent entre groupes.
Correction recommandée. Ne pas inverser le sens. En G1, soit supprimer ce construit, soit créer un autre construit explicitement nommé « préférence pour l'absence de contact », mais seulement après développement d'échelle.
- P0
Variable dépendante de G3
Erreur de designDiagnostic. Le scénario étendu remplaçait l'acceptation par l'intention d'évitement en contexte captif.
Pourquoi c'est important. Une VD différente empêche une vraie comparaison multi-groupes avec G1/G2 et ne répond plus exactement à la question « accepter de consommer un plat préparé par un robot ».
Correction recommandée. Conserver l'intention d'accepter/consommer comme VD primaire commune. Mesurer l'évitement seulement comme VD secondaire si le scénario stipule explicitement l'absence d'alternative humaine.
État dans cette version. Le scénario étendu mesure désormais les deux intentions dans les trois groupes ; la recommandation porte sur le choix de la variable dépendante primaire pour la comparaison.
- P0
H25 comparaison multi-groupes
Erreur méthodologiqueDiagnostic. H25 agrège plusieurs jugements de « dominance » de routes différentes et mélange des construits absents de certains groupes.
Pourquoi c'est important. Ce n'est pas une hypothèse unitaire ; les coefficients non communs ne sont pas comparables entre groupes.
Correction recommandée. Limiter PLS-MGA aux chemins strictement communs, après test MICOM ; formuler une hypothèse par différence de coefficient si elle est théoriquement justifiée.
P1 Corrections et re-spécifications recommandées
- P1
Plaisir comme « socle commun »
À corrigerDiagnostic. Le plaisir anticipé est déclaré commun puis absent de G1.
Pourquoi c'est important. Un socle commun doit avoir des construits et items identiques pour permettre MICOM/MGA.
Correction recommandée. Renommer « noyau transversal » et ne considérer comme communs que compétence, adéquation et intention (plus contrôles communs).
- P1
SC3 « malaise » qualifié de médiateur
À corrigerDiagnostic. Le schéma ne spécifie pas clairement un antécédent du malaise dans le socle ; H3 ne teste que malaise → intention.
Pourquoi c'est important. Un médiateur suppose un chemin X → M → Y.
Correction recommandée. Soit requalifier le malaise en antécédent, soit spécifier l'antécédent (p. ex. anthropomorphisme/inattendu) et tester la médiation.
- P1
H13 chaleur → intention
À re-spécifierDiagnostic. Les références centrales mobilisées étudient surtout chaleur → valeur relationnelle/émotionnelle, pas un effet direct simple vers l'intention.
Pourquoi c'est important. Transformer un effet médié en effet direct fragilise l'hypothèse.
Correction recommandée. Si chaleur est retenue, reproduire la chaîne médiée ; sinon l'écarter au profit d'un antécédent direct mieux documenté comme enjoyment.
- P1
H14 sécurité physique → intention
À re-spécifierDiagnostic. Chez Molinillo et al., la sécurité prédit l'attitude, pas directement la willingness dans la spécification publiée.
Pourquoi c'est important. Le sens peut être correct mais le chemin testé par la source n'est pas celui proposé.
Correction recommandée. Ne pas citer Molinillo comme preuve d'un chemin direct. Retenir plutôt le handling hygiénique, directement relié à l'intention chez Figueiredo et al.
- P1
H6 apparence × contact alimentaire
À supprimer du socleDiagnostic. La « réconciliation » proposée (anthropomorphisme positif sans contact, négatif avec contact) n'est pas soutenue de façon stable : Xiao & Zhao trouvent un bénéfice sur la qualité prédite du plat, tandis que Lee & Kwak trouvent une préférence pour des robots moins anthropomorphes en cuisine ET service ; McShane et al. trouvent un coût moral des humanoïdes en foodservice.
Pourquoi c'est important. Une interaction universelle serait une nouvelle théorie, pas une synthèse établie.
Correction recommandée. Ne pas faire de H6 une hypothèse transversale. Si l'apparence est manipulée, la traiter comme facteur expérimental propre au contexte et annoncer les mécanismes concurrents.
- P1
H11 aversion aux germes × compétence
À déclasserDiagnostic. L'échelle d'aversion aux germes est validée, mais les sources citées ne démontrent pas ce rôle modérateur précis sur compétence → intention de robot nettoyeur.
Pourquoi c'est important. Hypothèse trop spécifique par rapport aux preuves disponibles.
Correction recommandée. Traiter l'aversion aux germes comme contrôle/modérateur exploratoire, pas comme hypothèse centrale.
- P1
H12 tâche dégoûtante
À re-spécifierDiagnostic. Hoang & Tran comparent robot vs humain selon le caractère dégoûtant/perturbateur de la tâche ; cela ne démontre pas la modération proposée de « adéquation → intention » dans un échantillon ne voyant qu'un robot.
Pourquoi c'est important. Le test exige un comparateur humain et une manipulation de tâche.
Correction recommandée. Ne conserver H12 que dans un plan robot/humain × tâche ; sinon utiliser le résultat comme justification de contexte, pas comme hypothèse testée.
- P1
H18 transparence opérationnelle
À re-spécifierDiagnostic. Buell et al. démontrent le mécanisme avec des employés humains. L'hypothèse « positif humain / nul ou négatif robot » exige un facteur agent humain vs robot.
Pourquoi c'est important. Le plan du scénario étendu ne contient pas explicitement ce comparateur dans G3.
Correction recommandée. Soit ajouter le facteur humain/robot, soit transformer la transparence en voie exploratoire et ne pas l'inclure dans le modèle principal.
- P1
H24 néophobie « modère l'ensemble des relations »
À réécrireDiagnostic. Aucune des sources citées ne justifie une modération uniforme de tous les chemins.
Pourquoi c'est important. C'est une hypothèse omnibus pratiquement irréfutable et très coûteuse en puissance.
Correction recommandée. Limiter la modération à une relation théoriquement précise ; sinon utiliser la néophobie technologique alimentaire comme covariable/segmentation.
- P1
Nombre de construits/extensions
À simplifierDiagnostic. La page du DRA annonce une réplication-extension avec une ou deux variables propres au robot ; le scénario étendu propose quatre à six extensions par contexte.
Pourquoi c'est important. Le modèle devient trop lourd pour un DRA de L3 et accroît HTMT, VIF, alpha-error et besoin d'échantillon.
Correction recommandée. Ramener chaque modèle à 2 construits communs + 2 extensions contextuelles + 1 VD (+ contrôles).
- P1
Validité discriminante
Point fort à renforcerDiagnostic. La règle « un construit par famille » est utile, mais Fornell-Larcker et les charges croisées ne doivent pas être présentés comme des équivalents du HTMT.
Pourquoi c'est important. Henseler et al. montrent que Fornell-Larcker et les cross-loadings détectent mal certains défauts de validité discriminante.
Correction recommandée. Faire du HTMT (avec bootstrap) le diagnostic principal ; utiliser un seuil conservateur .85 pour construits proches ; prétest cognitif avant collecte.
- P1
MGA et recrutement séparé
À corrigerDiagnostic. Le DRA 2025-2026 reconnaît que les trois bases avaient été recrutées séparément ; les différences peuvent venir des répondants plutôt que du contexte.
Pourquoi c'est important. Sans assignation ou équilibre des échantillons, l'effet « contexte » est confondu avec la composition des groupes.
Correction recommandée. Si comparaison inter-contextes visée : recrutement commun puis assignation aléatoire des stimuli, ou au minimum quotas/contrôles + MICOM avant MGA.
P2 Points forts à conserver
- P2
Manipuler plutôt que mesurer l'anthropomorphisme
À conserverDiagnostic. Bonne décision pour réduire le recouvrement avec human-likeness, présence sociale, chaleur et animacy.
Pourquoi c'est important. Réduit fortement le risque HTMT dans la famille « humanité du robot ».
Correction recommandée. Conserver seulement si le plan expérimental et la puissance le permettent ; ajouter un manipulation check séparé.
- P2
Séparer traits et états
À conserverDiagnostic. Bonne règle : néophobie/aversion aux germes = traits ; propreté/malaise/risque = états.
Pourquoi c'est important. Améliore la validité discriminante et la logique causale.
Correction recommandée. Conserver ; éviter de mettre plusieurs traits proches dans le même modèle.
5.3 Limites et points restant à trancher
Plusieurs points appellent une décision ou une vérification complémentaire.
- L'échelle SRPC de Jia, Chi et Lu (2024), qui est l'instrument le plus prometteur pour mesurer la préoccupation de surveillance en chambre, n'a pas pu être consultée en texte intégral : ses dimensions et ses items doivent être récupérés avant toute mobilisation.
- Le modèle G3 du scénario étendu retient huit antécédents latents, la coercition en variable de contexte et l'opposition morale au remplacement (McShane et al., 2026) comme dimension affective de la menace sur l'emploi. Il reste à vérifier au pré-test l'unidimensionnalité du construit « menace sur l'emploi du personnel connu » avec ses items cognitifs et moraux ; si elle n'est pas obtenue, la dimension morale sera traitée comme médiateur en chaîne (menace → indignation → évitement) plutôt que comme construit parallèle.
- Deux publications portent exactement sur le contexte du groupe G3 — Min, Martinez et Stringam (2025, IJHM ; 2026, Journal of Foodservice Business Research) sur les robots de livraison en restauration sous contrat — mais leurs résumés n'ont pas pu être consultés. Elles sont à lire en priorité via l'accès institutionnel.
- La saillance de la menace sanitaire, qui inversait la préférence humain-robot au plus fort de la pandémie (Kim et al., 2021), a probablement décru depuis 2023. La traiter en variable de contrôle situationnelle plutôt qu'en antécédent est prudent — et vérifier empiriquement cette décroissance est en soi une contribution modeste mais propre.
- Les indicateurs bibliométriques de la section 2.1 (citations Semantic Scholar, co-citations Crossref) sont des arguments d'aide à la décision et non des résultats reproductibles par les étudiants : ils sont présentés comme tels.
- Les effets du genre sont contradictoires dans la littérature vérifiée : Parvez et al. (2024) et Ayyildiz et al. (2022) trouvent les femmes plus favorables, Binesh et Baloglu (2023) et Ivanov et al. (2018) trouvent l'inverse. Le genre doit donc rester une variable de contrôle et ne pas faire l'objet d'une hypothèse.
Une dernière remarque, qui déborde le cadre méthodologique. La littérature vérifiée est dominée par la Corée du Sud, la Chine, Taïwan, les États-Unis, la Thaïlande, l'Espagne et Singapour. La recherche systématique le confirme : aucune étude quantitative à comité de lecture sur un échantillon français, la seule trace empirique française étant une netnographie en cours au CERTOP. C'est une contribution disponible, et elle ne coûte rien de plus que la collecte déjà prévue.
6. Implications : les modèles proposés
6.1 Deux scénarios de modèle
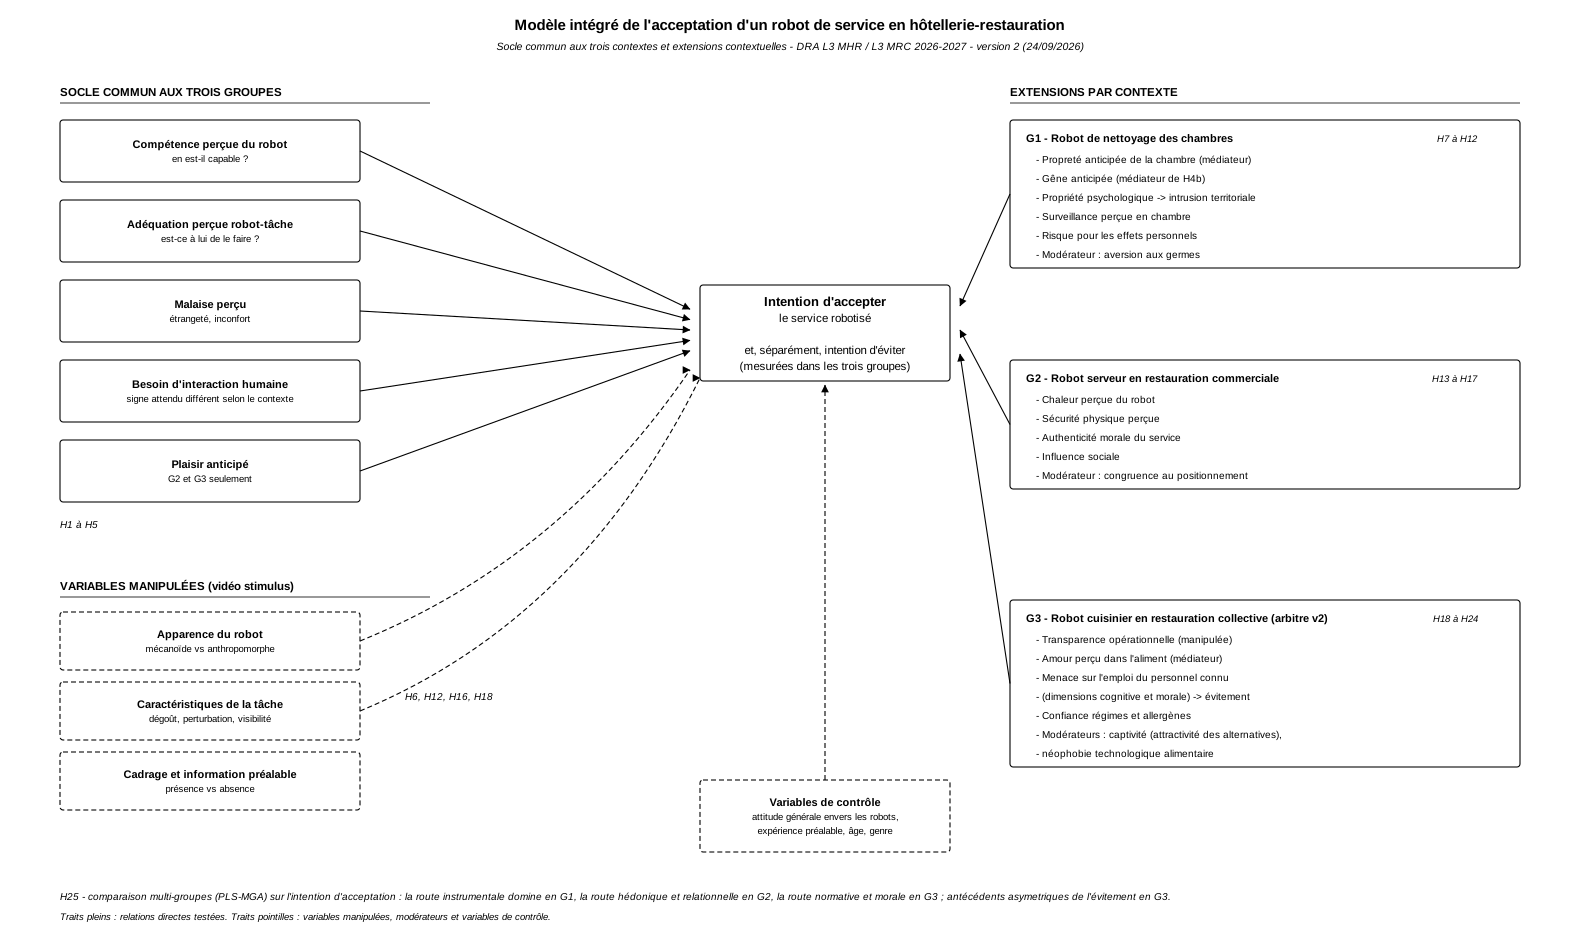
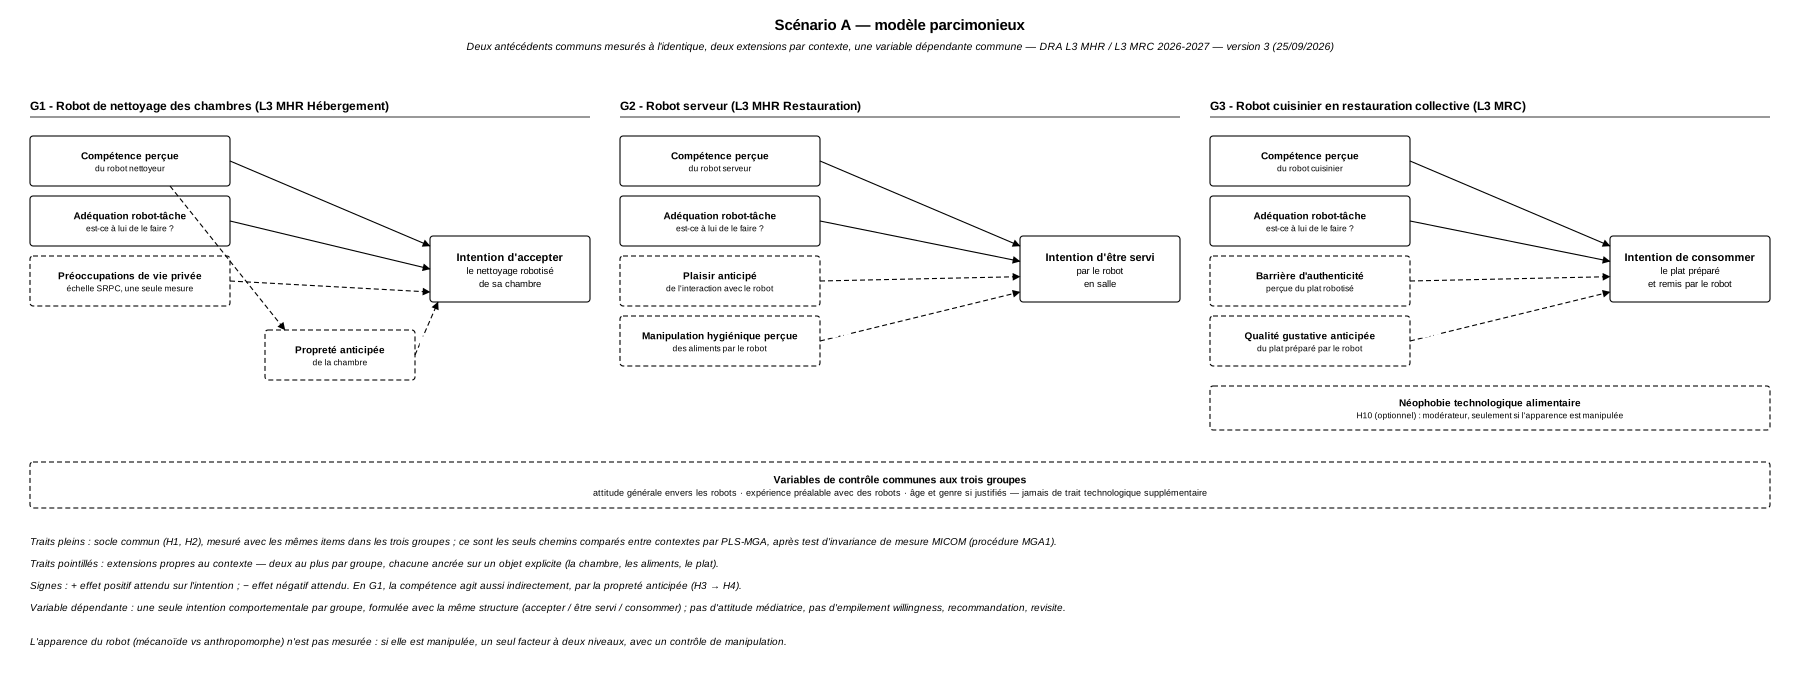
Deux lectures de l'inventaire coexistent, et elles ne sont pas contradictoires : elles arbitrent différemment entre la richesse des pistes et la propreté du test. Le scénario A, issu de l'audit, est parcimonieux : deux antécédents communs mesurés à l'identique, deux extensions par contexte, une variable dépendante commune — la forme la plus proche de la réplication-extension « à une ou deux variables propres » annoncée en début d'année. Le scénario B, issu de la note de synthèse, est étendu : un socle de cinq construits, deux variables dépendantes, quatre à six extensions par contexte et plusieurs variables manipulées. Les deux partent de la même problématique, des mêmes règles de spécification et de la même bibliographie ; ils diffèrent par le nombre de construits et par le niveau de preuve exigé pour qu'un antécédent entre dans le modèle collectif. Le choix se fait en séance ; les extensions non retenues collectivement restent des candidates pour l'angle individuel du second semestre.
6.2 Scénario A — le modèle parcimonieux
Le noyau transversal ne comporte que la compétence perçue, l'adéquation robot-tâche et l'intention d'accepter, avec les mêmes items dans les trois contextes ; l'attitude générale envers les robots reste une covariable, jamais un médiateur. Chaque groupe ajoute deux extensions, choisies parmi les antécédents dont le niveau de preuve est direct ou proche : pour le nettoyage des chambres, la propreté anticipée en médiateur et une mesure unique des préoccupations de vie privée ; pour le robot serveur, le plaisir anticipé et la manipulation hygiénique perçue ; pour le robot cuisinier, la barrière d'authenticité et la qualité gustative anticipée du plat. La comparaison entre groupes ne porte que sur les deux chemins communs, après vérification de l'invariance de mesure.
| Code | Contexte | Hypothèse | Fondement principal | Pourquoi ce choix | Statut |
|---|---|---|---|---|---|
| H1 | Tous | + La compétence perçue du robot influence positivement l'intention d'accepter le service robotisé. | Hoang & Tran (2022); Begum et al. (2025); Topsakal et al. (2026); Parvez et al. (2025) | Un seul représentant de la famille performance. | COMMUN |
| H2 | Tous | + L'adéquation perçue entre le robot et la tâche influence positivement l'intention d'accepter le service robotisé. | Hoang & Tran (2022); Hu & Min (2026) | Capacité (H1) ≠ légitimité/adéquation (H2). Items à prétester cognitivement. | COMMUN |
| H3 | G1 | + La compétence perçue du robot de nettoyage influence positivement la propreté anticipée de la chambre. | Hoang & Tran (2022) | Reprend exactement le mécanisme le mieux documenté. | RETENIR |
| H4 | G1 | + La propreté anticipée de la chambre influence positivement l'intention d'accepter le nettoyage robotisé. | Hoang & Tran (2022) | Outcome concret du housekeeping. | RETENIR |
| H5 | G1 | − Les préoccupations de vie privée liées au robot de chambre influencent négativement l'intention d'accepter le nettoyage robotisé. | Jia et al. (2024); Song et al. (2024); Xie & Lei (2022) | Une seule mesure SRPC, pas trois risques voisins. | RETENIR |
| H6 | G2 | + Le plaisir anticipé de l'interaction avec le robot serveur influence positivement l'intention d'être servi par ce robot. | Topsakal et al. (2026); Figueiredo et al. (2026); Molinillo et al. (2023) | Effet répliqué, spécifique à l'expérience en salle. | RETENIR |
| H7 | G2 | + La manipulation hygiénique perçue des aliments par le robot serveur influence positivement l'intention d'être servi par ce robot. | Figueiredo et al. (2026) | Construit récent, validé et distinct de la compétence. | RETENIR |
| H8 | G3 | − La barrière d'authenticité perçue influence négativement l'intention de consommer un plat préparé et remis par le robot. | Huang et al. (2023) | Spécifique à la préparation alimentaire; éviter de cumuler avec « amour » et authenticité morale. | RETENIR |
| H9 | G3 | + La qualité gustative anticipée du plat préparé par le robot influence positivement l'intention de le consommer. | Huang et al. (2023); Xiao & Zhao (2022) | Le goût/qualité du plat est un résultat propre à la cuisine robotisée et évite d'inférer un chemin intentionnel non testé chez Pancer. | RETENIR |
| H10 | G3 (option) | La néophobie technologique alimentaire renforce l'effet défavorable des caractéristiques du robot qui signalent une forte anthropomorphisation sur son image globale. | Choi (2026) | À n'utiliser que si l'apparence est réellement manipulée et si la puissance est suffisante. | OPTIONNEL |
| MGA1 | Comparaison | Après établissement de l'invariance MICOM, comparer uniquement H1 et H2 entre les trois contextes, sans hypothèse de « route dominante » omnibus. | Henseler, Ringle & Sarstedt (2016) | Rend la comparaison statistiquement défendable. | PROCÉDURE |
Protocole de mesure et d'analyse du scénario A
- VD commune. Conserver une intention comportementale unique, formulée avec la même structure syntaxique dans les trois contextes (accepter/choisir/consommer). Ne pas empiler willingness, recommandation, revisite et attitude.
- Pré-test. Pré-test cognitif des items (≈10–15 personnes/contextes) avant la collecte; supprimer/reformuler les items ambigus avant, jamais « purifier » le construit uniquement après HTMT.
- Validité discriminante. HTMT comme diagnostic principal; seuil conservateur .85 pour construits proches, bootstrap de l'HTMT. Ne pas présenter Fornell–Larcker/cross-loadings comme preuve suffisante.
- PLS-MGA. Comparer seulement les construits communs, après MICOM. Sans invariance de composition, pas d'interprétation causale des différences de coefficients.
- Échantillonnage. Si la comparaison de contextes est centrale, utiliser un même vivier de répondants assignés aléatoirement aux stimuli; sinon documenter et contrôler les différences de composition des échantillons.
- Stimulus. Éviter un plan factoriel trop riche. Avec ≈240–280 répondants/contextes attendus, un seul facteur expérimental à 2 niveaux est déjà plus prudent qu'un 2×2 ou 2×2×2.
- Contrôles. Limiter aux contrôles conceptuellement nécessaires : expérience préalable avec robots, attitude générale envers robots, âge/genre si justifiés. Ne pas multiplier les traits technologiques voisins.
6.3 Scénario B — le modèle étendu
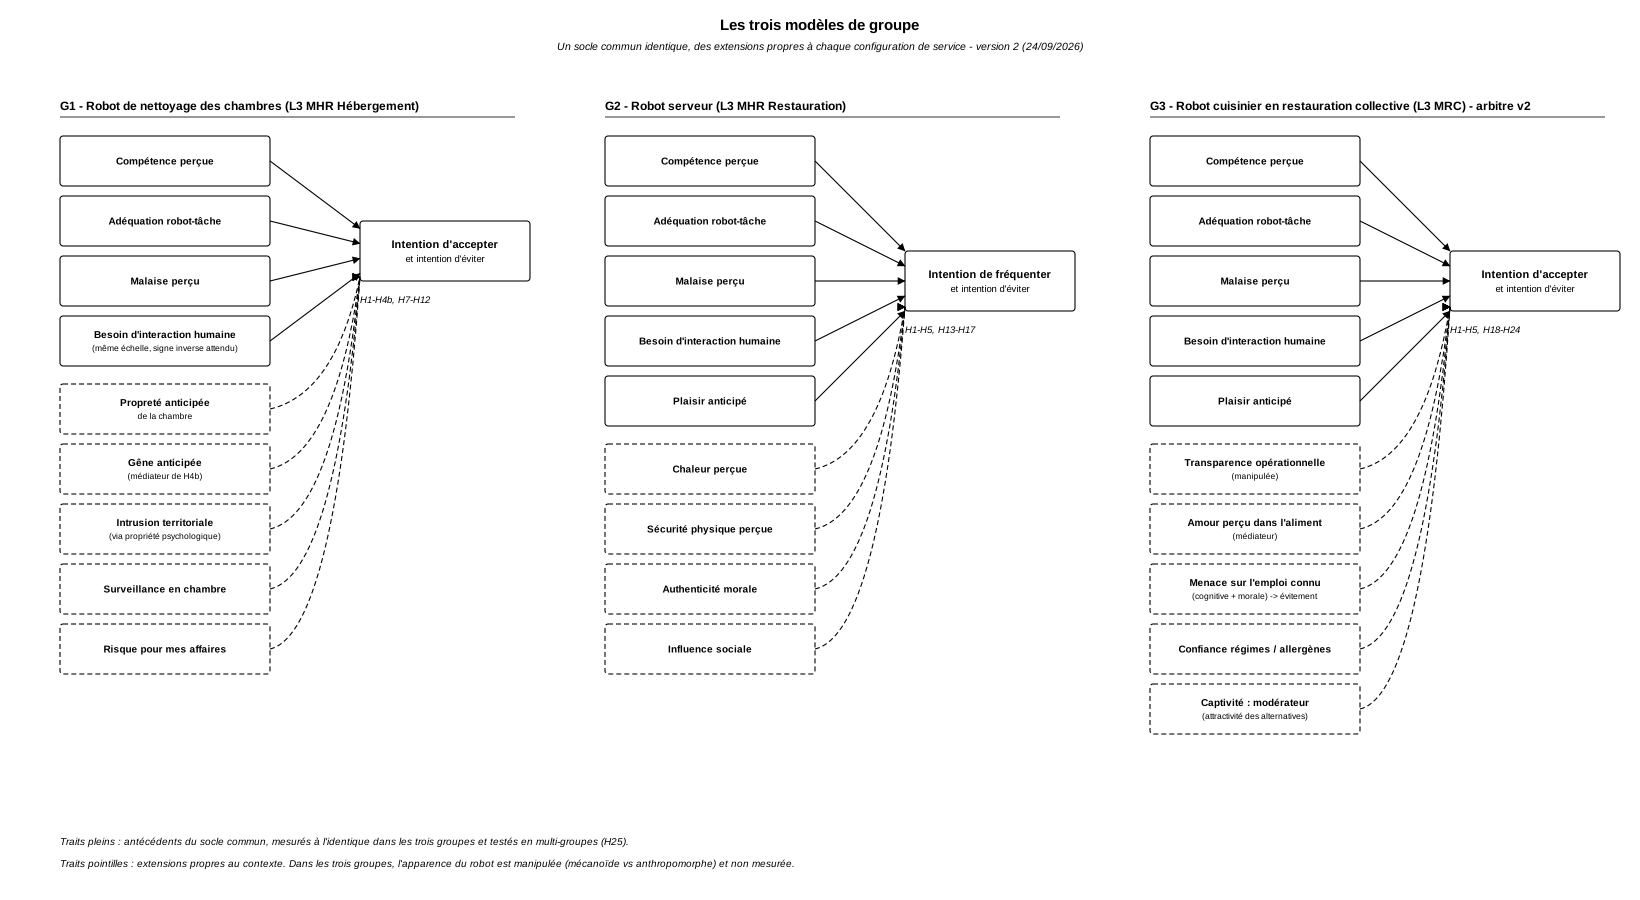
Le modèle repose sur un socle commun mesuré à l'identique dans les trois groupes, ce qui autorise une comparaison multi-groupes, et sur deux à six extensions propres à chaque configuration. Chaque construit du socle est l'unique représentant de sa famille conceptuelle.
Le socle commun
| Construit | Rôle | Pourquoi celui-là |
|---|---|---|
| Compétence perçue du robot | Antécédent — route instrumentale | Unique représentant de la famille de la performance ; en C1, il prend la forme validée de la compétence perçue du nettoyeur (Hoang & Tran, 2022). |
| Adéquation perçue robot-tâche | Antécédent — route normative | Construit le plus discriminant et le plus original. Il demande « est-ce à lui de le faire ? » là où la compétence demande « en est-il capable ? ». |
| Malaise perçu | Médiateur affectif unique | Remplace les émotions génériques de l'AIDUA. État réactif au stimulus, distinct de l'anxiété technologique qui est un trait. |
| Besoin d'interaction humaine | Antécédent — route sociale | Le seul construit dont le signe attendu diffère selon le contexte : négatif en restauration, positif en hébergement où l'absence de contact est un bénéfice. |
| Plaisir anticipé | Antécédent — route hédonique (G2 et G3) | Conservé du modèle 2025-2026, mais délibérément absent du modèle G1 : un service invisible n'offre ni spectacle ni amusement. |
| Intention d'accepter et intention d'éviter | Deux variables dépendantes distinctes | Acceptation (Gursoy et al., 2019, 3 items) et évitement (Lee & Kim, 2026, 4 items) mesurés dans les trois groupes ; distinction vérifiée par AFC, HTMT < 0,85. |
| Apparence du robot | Variable manipulée | Mécanoïde contre anthropomorphe, dans la vidéo stimulus. Supprime du modèle de mesure la famille conceptuelle la plus problématique. |
| Attitude générale envers les robots | Contrôle exogène | Covariable obligatoire : sans elle, les construits spécifiques capteraient une simple technophilie. |
Les extensions par groupe
Le groupe hébergement ajoute la propreté anticipée de la chambre en médiateur, l'intrusion territoriale perçue, la préoccupation de surveillance et le risque pour les effets personnels, avec l'aversion aux germes en modérateur et le caractère répugnant de la tâche en manipulation. Le groupe restauration commerciale ajoute la chaleur perçue, la sécurité physique perçue, l'authenticité morale du service et l'influence sociale, avec la congruence au positionnement de l'établissement en manipulation. Le groupe restauration collective ajoute la transparence opérationnelle en manipulation, l'amour perçu dans l'aliment en médiateur, la menace sur l'emploi du personnel connu (dimensions cognitive et morale) orientée vers l'évitement, et la confiance dans le respect des régimes et des allergènes, avec la captivité (attractivité des alternatives) et la néophobie technologique alimentaire en modérateurs. Dans les trois groupes, l'intention d'accepter et l'intention d'éviter sont mesurées séparément.
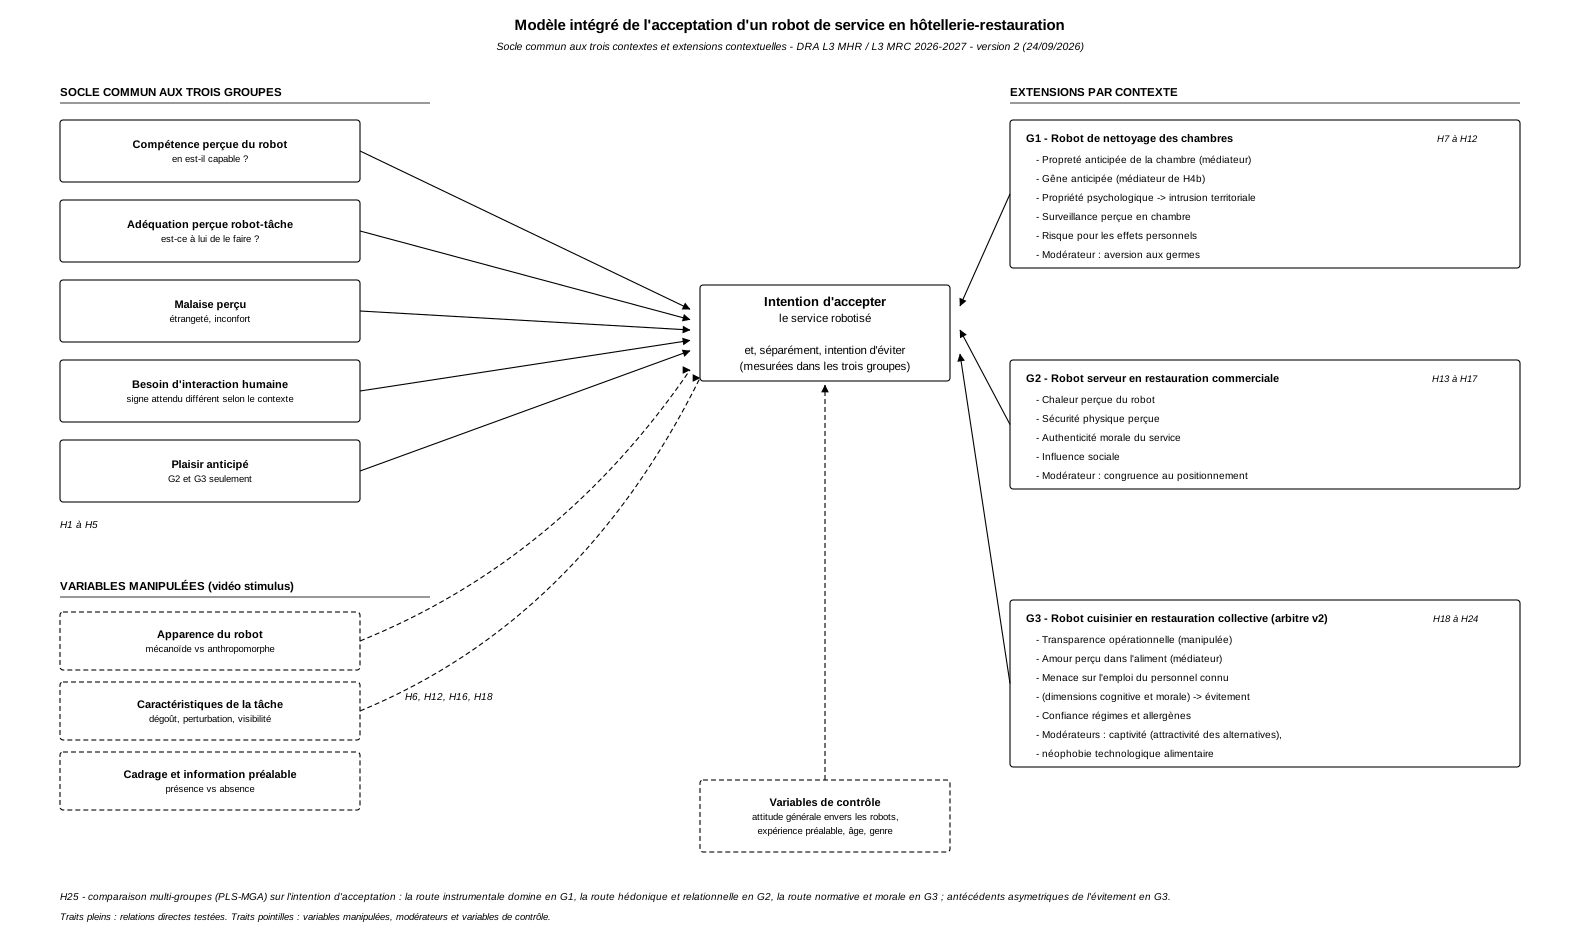
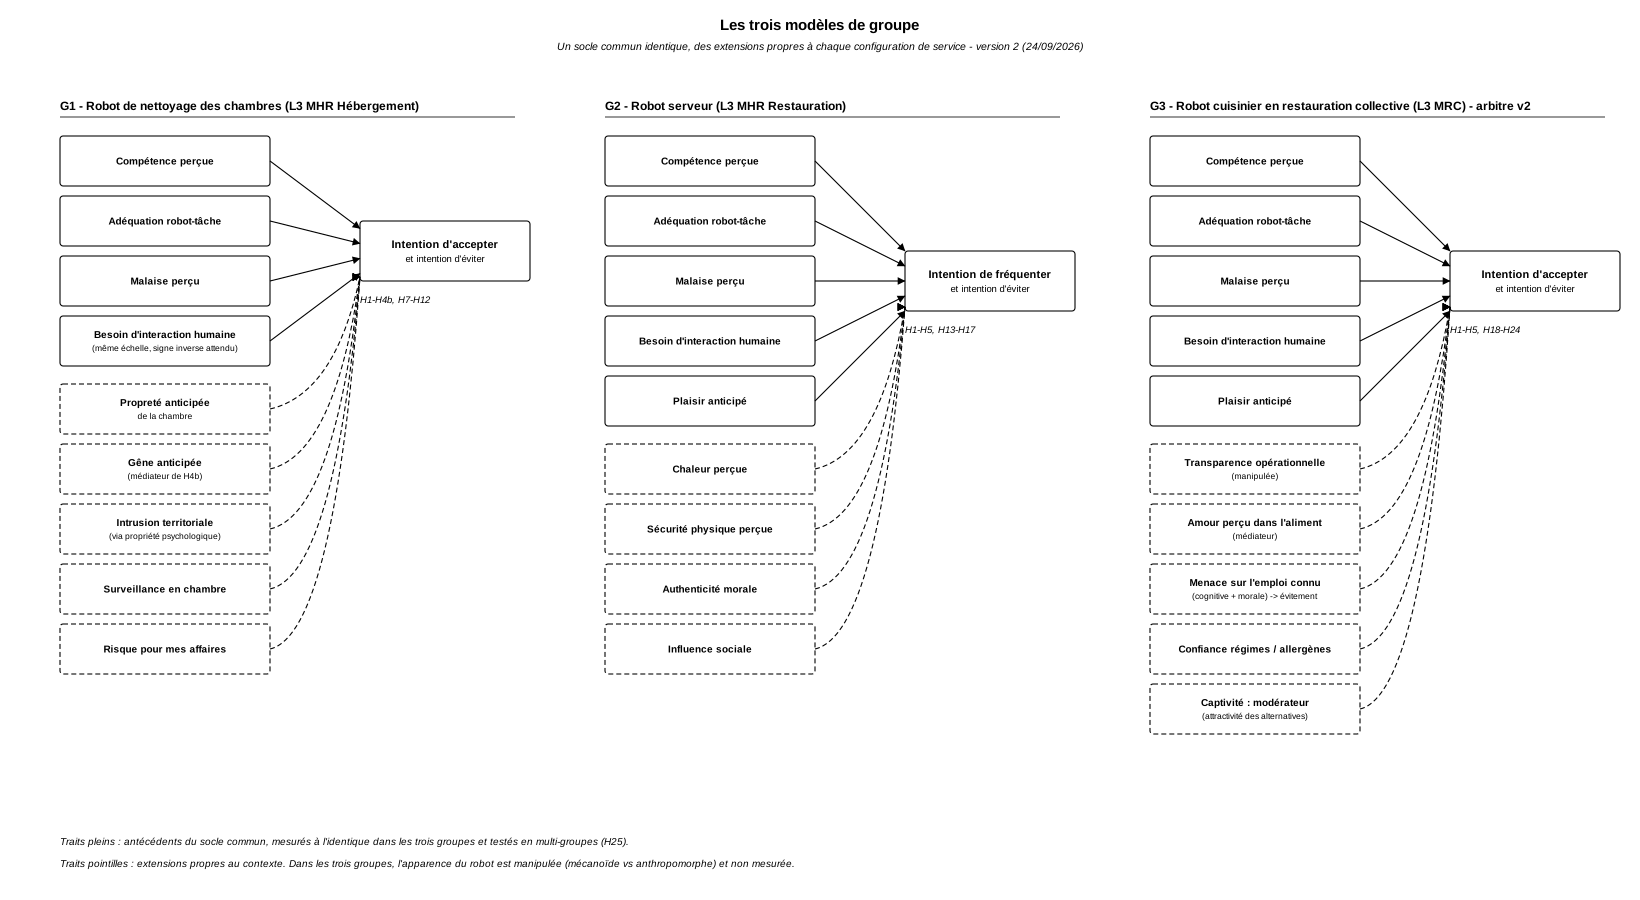
Les hypothèses du scénario B
Vingt-cinq hypothèses sont proposées, plus une hypothèse de mesure : le socle commun, les extensions par groupe et une hypothèse transversale de comparaison. Le tableau ci-dessous les reprend sous forme abrégée ; l'énoncé complet et l'ancrage bibliographique de chacune figurent dans l'onglet « Modèle et hypothèses » du classeur.
| Code | Énoncé abrégé | Ancrage principal |
|---|---|---|
| H1 | Compétence perçue → intention (+) | Hoang & Tran (2022) ; Begum et al. (2025) |
| H2 | Adéquation robot-tâche → intention (+), au-delà de la compétence ; plus élevée pour les tâches objectives, plus faible pour les tâches émotionnelles ou symboliques | Huang & Rust (2018) ; Castelo et al. (2019) ; Longoni & Cian (2022) ; Liu et al. (2026) ; Peng et al. (2026) |
| H3 | Malaise perçu → intention (−) | Mende et al. (2019) ; Baek et al. (2025) |
| H4a | Besoin d'interaction humaine → intention (−) en G2 et G3 | Dabholkar (1996) ; Shin & Jeong (2020) |
| H4b | Besoin d'interaction humaine → intention (+) en G1, médiation par la gêne anticipée | Pitardi et al. (2022, 2024) ; Holthöwer & van Doorn (2023) — hypothèse forte |
| H5 | Plaisir anticipé → intention (+) en G2 et G3 ; sans objet en G1 | Gursoy et al. (2019) ; Molinillo et al. (2022) |
| H6 | L'effet de l'apparence dépend du contact avec l'aliment | Xiao & Zhao (2022) contre Lee & Kwak (2025) — réconciliation |
| H7 | Compétence → propreté anticipée → intention (médiation) | Hoang & Tran (2022) ; Vos et al. (2019) |
| H8 | Intrusion territoriale → intention (−), d'autant plus forte que la propriété psychologique de la chambre est élevée | Construit nouveau ; Jiang, Balaji & Lyu (2026) |
| H9 | Surveillance perçue en chambre → intention (−) | Jia et al. (2024) ; Song B. et al. (2024) |
| H10 | Risque pour les effets personnels → intention (−) | Construit nouveau ; Park (2020) |
| H11 | L'aversion aux germes modère compétence → intention | Duncan et al. (2009) ; Shin & Kang (2020) |
| H12 | Le caractère répugnant de la tâche inverse le désavantage du robot | Hoang & Tran (2022) — réplication |
| H13 | Chaleur perçue → intention (+), distincte de la compétence | Belanche et al. (2021) ; Choi et al. (2021) |
| H14 | Sécurité physique perçue → intention (+) | Jang & Lee (2020) ; Molinillo et al. (2022) |
| H15 | Authenticité morale → intention (+) ; le robot la dégrade | Song X. et al. (2022) ; Cheng et al. (2026) |
| H16 | La congruence au positionnement modère l'adéquation perçue | Hu & Min (2025) ; Kao & Huang (2023) |
| H17 | Influence sociale → intention (+), propre à la consommation publique | Chi et al. (2022) ; Zemke et al. (2025) |
| H18 | La transparence opérationnelle n'opère pas pour un agent robotique | Buell, Kim & Tsay (2017) — jamais testé, hypothèse centrale |
| H19 | L'amour perçu dans l'aliment médie l'effet de l'automatisation | Pancer et al. (2025) ; Fuchs et al. (2015) |
| H21 | Confiance régimes et allergènes → intention (+) | Construit nouveau ; Huang et al. (2023) |
| H22 | La captivité (faible attractivité des alternatives) modère l'effet de la menace sur l'emploi et du malaise sur l'évitement | Lee & Kim (2022) ; Lee & Kim (2026) ; Kim, Ng & Kim (2009) |
| H23 | Menace sur l'emploi du personnel connu (cognitive + morale) → évitement (+), amplifiée par la proximité relationnelle ; n.s. en commercial | Etemad-Sajadi et al. (2022) ; Granulo et al. (2019, 2025) ; McShane et al. (2026) — inédite |
| H24 | La néophobie technologique alimentaire modère l'ensemble | Cox & Evans (2008) ; Ross et al. (2022) |
| H25 | Sur l'acceptation, la structure des déterminants diffère entre configurations (PLS-MGA) ; sur l'évitement, antécédents asymétriques en G3 | Chi et al. (2022) ; Hu & Min (2025) ; Claudy et al. (2015) |
| VD | Acceptation et évitement sont deux construits distincts (HTMT < 0,85), moins corrélés en contexte captif | Gursoy et al. (2019) ; Cenfetelli (2004) ; Liang & Xue (2009) |
Énoncé complet · classeur, onglet « Modèle et hypothèses »
Chaque hypothèse du scénario étendu, avec l'ancrage bibliographique qui la justifie. Le tableau abrégé ci-dessus en donne la lecture rapide.
Socle commun — les trois groupes
- H1
La compétence perçue du robot influence positivement l'intention d'accepter le service robotisé.
Ancrage Hoang & Tran (2022) ; Belanche et al. (2021) ; Chen & Girish (2023) ; Begum et al. (2025, r=0,707 pour la performance expectancy) ; Gong, Guan & Huan (2025)
- H2
L'adéquation perçue robot-tâche influence positivement l'intention, au-delà de la compétence perçue ; elle est d'autant plus élevée que la tâche est objective, mécanique et standardisee, et d'autant plus faible qu'elle est subjective, émotionnelle ou symbolique.
Ancrage Hoang & Tran (2022) ; Ivanov & Webster (2019) ; Huang & Rust (2018) ; Castelo, Bos & Lehmann (2019) ; Longoni & Cian (2022) ; Yang, Wang, Song & Ma (2024) ; Liu, Wang & Wu (2026) ; Peng et al. (2026)
- H3
Le malaise perçu influence négativement l'intention.
Ancrage Mende et al. (2019) ; Kim S. Y. et al. (2019) ; Baek et al. (2025) ; El Halabi & Trendel (2024)
- H4a
En restauration (G2, G3), le besoin d'interaction humaine influence négativement l'intention.
Ancrage Dabholkar (1996) ; Shin H. H. & Jeong (2020) ; Yoganathan et al. (2021) ; Sung & Jeon (2020)
- H4b
En hébergement (G1), le besoin d'interaction humaine influence POSITIVEMENT l'intention d'accepter le nettoyage robotisé, et cet effet est médiatise par la gêne anticipée : le client se sent moins expose au jugement d'un robot qu'a celui d'un agent humain.
Ancrage Pitardi, Wirtz, Paluch & Kunz (2022, 2024) ; Holthower & van Doorn (2023) ; Shin H. & Kang J. (2020) ; Kim S. et al. (2021) - hypothèse forte, réfutable
- H5
En restauration (G2, G3), le plaisir anticipé influence positivement l'intention ; il est sans objet en hébergement (G1), puisque le service s'exécute hors de la présence du client.
Ancrage Gursoy et al. (2019) ; Molinillo et al. (2022) ; Kim, Park & Jeon (2021) - et absence structurelle en C1
- H6
L'effet de l'apparence du robot (mécanoïde vs anthropomorphe) sur l'intention est modère par le contexte : positif la ou le robot n'entre pas en contact avec l'aliment, négatif la ou il le manipule, et négatif dans l'espace privé de la chambre.
Ancrage Xiao & Zhao (2022) vs Lee & Kwak (2025) ; Blut et al. (2021) ; Yoganathan et al. (2021) ; Holthower & van Doorn (2023) ; Peng et al. (2026) - HYPOTHÈSE DE RÉCONCILIATION
- VD
L'intention d'accepter et l'intention d'eviter le service robotisé sont deux construits distincts (HTMT < 0,85), mesures dans les trois groupes ; leur corrélation est plus faible en contexte captif (G3), signe d'ambivalence.
Ancrage Gursoy et al. (2019, r = -0,613) ; Cenfetelli (2004) ; Liang & Xue (2009) ; Koverola et al. (2022) ; Ud Din & Van Riel (2026)
G1 — Robot de nettoyage des chambres
- H7
La compétence perçue du robot nettoyeur influence positivement la propreté anticipée de la chambre, qui influence positivement l'intention (médiation).
Ancrage Hoang & Tran (2022) ; Vos et al. (2019) ; Shin H. & Kang J. (2020) ; Wang, Zou & So (2025)
- H8
L'intrusion territoriale perçue influence négativement l'intention ; elle est d'autant plus forte que la propriété psychologique de la chambre est élevée (chaîne causale).
Ancrage Construit NOUVEAU ; Jiang, Balaji & Lyu (2026, propriété psychologique) ; Lutz, Schottler & Hoffmann (2019) ; en tension avec Hoang & Tran (2022)
- H9
La préoccupation de surveillance en chambre influence négativement l'intention.
Ancrage Jia, Chi & Lu (2024, SRPC) ; Kim, Erdem & Kim (2024) ; Lin, Lee, Choi & Andereck (2026, ERoSeR) ; Lutz & Tamo-Larrieux (2021)
- H10
Le risque perçu pour les effets personnels influence négativement l'intention.
Ancrage Construit NOUVEAU ; ancrage : facette process de la confiance (Park, 2020) ; absent de la typologie de Pizam et al. (2024)
- H11
L'aversion aux germes modère positivement la relation entre compétence perçue et intention : plus elle est forte, plus le robot est preferable à l'agent humain.
Ancrage Duncan, Schaller & Park (2009) ; Shin H. & Kang J. (2020) ; Kim S. et al. (2021) ; Romero & Lado (2021)
- H12
Le caractère dégoûtant de la tâche (salle de bains vs refection des lits) modère l'effet de l'adéquation perçue sur l'intention : le desavantage du robot s'inverse quand la tâche est repugnante.
Ancrage Hoang & Tran (2022, étude 2) - REPLICATION en contexte de chambre d'hôtel
G2 — Robot serveur
- H13
La chaleur perçue du robot influence positivement l'intention, et cet effet est distinct de celui de la compétence perçue.
Ancrage Fiske et al. (2002) ; Belanche et al. (2021) ; Zhu & Chang (2020) ; Choi S., Mattila & Bolton (2021) ; Song, Li, Leung & Mei (2024)
- H14
La sécurité physique perçue influence positivement l'intention.
Ancrage Jang H.-W. & Lee S. (2020, 3 items) ; Molinillo et al. (2022, beta=0,178)
- H15
L'authenticité morale perçue du service influence positivement l'intention, et le recours au robot la dégrade.
Ancrage Song X. et al. (2022) ; Cheng L. et al. (2026) ; Hu & Min (2025) ; Yang, Wang, Song & Ma (2024)
- H16
La congruence entre le robot et le positionnement de l'établissement (bistrot traditionnel vs fast-casual vs concept futuriste) modère l'effet de l'adéquation perçue sur l'intention.
Ancrage Hu & Min (2025) ; Kao & Huang (2023) ; Chi, Gursoy & Chi (2022) ; Choi, Liu & Choi (2022) ; Ma, Ge, Jia & Wang (2025)
- H17
L'influence sociale influence positivement l'intention ; cet effet est spécifique à la restauration commerciale, consommation publique et collective, et devrait s'atténuer avec la familiarite.
Ancrage Chi, Gursoy & Chi (2022) ; Zemke et al. (2025) ; Lin et al. (2020) ; contre-preuve sur usage réel : Chang et al. (2022) ; Topsakal et al. (2026, existence vérifiée, résumé non consulte)
G3 — Robot cuisinier en restauration collective
- H18
La transparence opérationnelle (préparation visible vs cuisine fermee) influence POSITIVEMENT l'intention lorsque le cuisinier est humain, mais cet effet est NUL OU NÉGATIF lorsque le cuisinier est un robot, parce que le mécanisme de l'effort perçu suppose un agent capable d'effort meritoire.
Ancrage Buell & Norton (2011) ; Buell, Kim & Tsay (2017, +22,2 % de qualité perçue avec des employés humains) - JAMAIS TESTÉ SUR UN AGENT ROBOTIQUE : hypothèse la plus originale du dispositif
- H19
L'amour perçu dans l'aliment médie négativement l'effet de l'automatisation sur l'intention.
Ancrage Pancer et al. (2025) ; Fuchs, Schreier & Van Osselaer (2015) ; Rodriguez (2024, contamination, netnographie française)
- H21
La confiance dans le respect des régimes et des allergènes influence positivement l'intention.
Ancrage Construit NOUVEAU ; ancrage : Huang D. et al. (2023, inflexibilite perçue) ; Kanwal et al. (2025) par analogie
- H22
La captivité du convive (faible attractivité des alternatives) MODÈRE l'effet de la menace sur l'emploi et du malaise perçu sur l'intention d'évitement : ces effets sont plus forts quand une alternative existe, et se reportent sur l'insatisfaction quand elle n'existe pas.
Ancrage Lee G. & Kim Y. (2022) ; Lee J.-M. & Kim S. (2026) ; Reinders et al. (2008) ; Kim W. G., Ng & Kim (2009)
- H23
La menace perçue sur l'emploi du personnel de service CONNU du convive (dimension cognitive : perte d'emploi ; dimension affective : indignation morale) influence positivement l'intention d'ÉVITEMENT, sans effet nécessaire sur l'intention d'acceptation ; cet effet, non significatif en restauration commerciale, est amplifie par la proximité relationnelle avec le personnel.
Ancrage Etemad-Sajadi et al. (2022, n.s. en commercial) ; Granulo, Fuchs & Puntoni (2019) ; Granulo et al. (2025) ; McShane et al. (2026) ; Chong & Zhang (2024) - HYPOTHÈSE INÉDITE
- H24
La néophobie technologique alimentaire modère négativement l'ensemble des relations du modèle.
Ancrage Cox & Evans (2008) ; Ross et al. (2022, effet total beta=-0,369) ; Choi J. (2026) ; Kanwal et al. (2025)
Hypothèse transversale
- H25
Sur l'intention d'ACCEPTATION, la structure des déterminants diffère entre les trois configurations (PLS-MGA) : la route instrumentale domine en G1, la route hédonique et relationnelle en G2, la route normative et morale en G3. Sur l'intention d'ÉVITEMENT, les antécédents sont asymetriques (menace sur l'emploi et captivité en G3 seulement).
Ancrage Chi, Gursoy & Chi (2022) ; Hu & Min (2025) ; Claudy, Garcia & O'Driscoll (2015) ; Liu, Wang & Wu (2026)
6.4 Comparer les deux scénarios
| Critère | Scénario A — parcimonieux | Scénario B — étendu |
|---|---|---|
| Socle commun | Compétence perçue, adéquation robot-tâche → intention (H1, H2) | Compétence perçue, adéquation robot-tâche, malaise perçu, besoin d'interaction humaine, plaisir anticipé (absent en G1) → intention (H1 à H5) |
| Extensions G1 (nettoyage) | Propreté anticipée (médiateur), préoccupations de vie privée (SRPC) | Propreté anticipée, gêne anticipée, intrusion territoriale, surveillance en chambre, risque pour les effets personnels ; aversion aux germes en modérateur |
| Extensions G2 (serveur) | Plaisir anticipé, manipulation hygiénique perçue | Chaleur perçue, sécurité physique perçue, authenticité morale, influence sociale ; congruence au positionnement en modérateur |
| Extensions G3 (cuisinier collectif) | Barrière d'authenticité, qualité gustative anticipée ; néophobie technologique alimentaire en modérateur optionnel | Transparence opérationnelle (manipulée), amour perçu dans l'aliment (médiateur), menace sur l'emploi du personnel connu, confiance régimes et allergènes ; captivité et néophobie en modérateurs |
| Variable dépendante | Une intention comportementale par groupe, de même structure (accepter, être servi, consommer) | Intention d'accepter et, séparément, intention d'éviter, mesurées dans les trois groupes |
| Variables manipulées | Au plus un facteur à deux niveaux (apparence), avec contrôle de manipulation | Apparence du robot ; caractéristiques de la tâche ; cadrage et information préalable ; transparence (G3) |
| Construits latents par groupe | 4 à 5, plus contrôles | 8 à 11 antécédents latents selon le groupe, deux intentions, plus contrôles |
| Comparaison multi-groupes | H1 et H2 seulement, après invariance MICOM (MGA1) | Structure des déterminants et antécédents asymétriques de l'évitement (H25) |
| Niveau de preuve des extensions | Direct ou proche pour chacune | Mêlé : direct, transposition et construits nouveaux |
| Ce qu'il permet | Un test propre et comparable ; une matrice HTMT lisible ; un dossier défendable en soutenance | Une exploration plus large et des angles individuels plus nombreux ; une contribution originale sur les construits nouveaux |
| Ce qu'il coûte | Renonce à plusieurs pistes originales (contagion, moralité, transparence, contrainte) | Questionnaire long, risque de recouvrement, puissance dispersée, hypothèses moins directement soutenues |
| À trancher en séance | Le socle commun retenu ; le nombre d'extensions par groupe ; la ou les variables dépendantes ; l'apparence du robot, manipulée ou fixée ; le plan de comparaison entre groupes. Les extensions du scénario B non retenues collectivement restent des candidates pour l'angle individuel du second semestre. | |
6.5 Protocole de collecte commun aux deux scénarios
La collecte reste séparée par groupe de contexte, conformément au choix retenu : chaque groupe interroge sa propre population sur son propre scénario, sans affectation aléatoire des répondants aux trois configurations. À raison d'une vingtaine de répondants par étudiant et de données mises en commun, chaque groupe devrait réunir entre 250 et 300 observations, ce qui est confortable pour un modèle de sept construits latents estimé en moindres carrés partiels.
Deux vidéos stimulus par groupe sont nécessaires, l'une présentant un robot d'aspect délibérément mécanique, l'autre un robot d'aspect anthropomorphe, le reste du scénario étant strictement identique. Ce plan à deux conditions suffit à tester H6 et à retirer du modèle de mesure la famille conceptuelle la plus encombrante.
Trois précautions de conception méritent d'être signalées aux étudiants dès la première séance de rédaction du questionnaire. La première concerne la traduction : les items de coercition perçue portent sur l'absence structurelle d'alternative et non sur la difficulté d'usage, or en français « je suis obligé de » glisse facilement vers « j'ai du mal à ». La deuxième concerne l'ancrage : chaque batterie d'items doit nommer explicitement son objet — ce robot, cet établissement, mon employeur, mes affaires, mon régime alimentaire — faute de quoi deux construits distincts fusionneront dans l'esprit du répondant. La troisième concerne la distinction entre la préoccupation égocentrée et la préoccupation altruiste : « je perds quelque chose » et « la personne qui me sert perd son poste » sont deux construits différents que les répondants confondront si les items ne les séparent pas explicitement.
Enfin, un pré-test cognitif sur une dizaine de répondants, mené avant la collecte, suffit généralement à détecter les items qui fusionnent. C'est un investissement d'une demi-journée qui évite le nettoyage a posteriori — lequel, rappelons-le, revient à redéfinir le construit sans le dire.